تعلم الآلة الكلاسيكيintermediateمعالج رسوميات اختياري~30 دقيقةColab
التسرّب، على مراحل
Leakage, Staged
التسريب يغيّر ما تصدّقه عن النموذج، لا النموذج الذي تُطلقه
يريد مستشفى نموذجاً يحدّد، لحظةَ خروج المريض، مَن يُرجَّح أن يعود إليه خلال 30 يوماً. ويستطيع فريق الرعاية الاتصال بـ20٪ من المرضى فقط. بين يديك سجلّ حالات الدخول لسنتين. تبني أولاً تقييماً نزيهاً، ثم تأخذ أربعة اختصارات تأخذها مشاريع حقيقية كل أسبوع، واحداً بعد آخر. كل اختصار منها يرفع درجة التحقّق المتقاطع. أمّا حالات دخول السنة التالية، لمرضى لم يرهم النموذج قطّ، فتبقى مختومة حتى النهاية. وحين تُفتح، يتبيّن أن ثلاثة من الاختصارات الأربعة لم تغيّر شيئاً سوى الرقم المكتوب في التقرير. أمّا الرابع فيفعل شيئاً لا يكاد مقياس التقرير نفسه يلحظه: يتوقّف التنبيه عن العمل.
الهدف
قيّم نموذجاً واحداً بخمسة بروتوكولات، يضيف كلٌّ منها تسريباً إلى ما قبله. ثم قارن كل درجة تحقّق متقاطع بالأداء على حالات دخول لاحقة لمرضى جدد، بقيت مختومة طوال العمل. بيّن أن تقدير البروتوكول النزيه يطابق الواقع، وميّز التسريبات التي تضخّم التقدير وحده من تلك التي تغيّر النموذج نفسه. وأخيراً قِس ما يفعله العمود المُسرَّب بالتنبيه بعد إطلاقه.
يفتح Colab نسخة للقراءة فقط. احفظ نسخة في Drive للاحتفاظ بتعديلاتك.
يحتاج الدفتر إلى لوحة مفاتيح — يُفضَّل فتحه على حاسوب مكتبي.
الأوراق وراء هذه الورشة
النموذج الذي يتسرّب إليه الجواب لا يبدو معطوباً. إنه يبدو ممتازاً. لا يظهر أيّ خطأ، والطيّات تتّفق فيما بينها، والدرجة هي الأفضل منذ بدأ المشروع. لهذا يُعدّ التسرّب أكثر الطرق شيوعاً لفشل المشاريع الحقيقية: كل علامة تحذير فيه تشبه النجاح.
هذه الورشة تعرض هذا الفشل عن قصد. تبدأ بتقييم نزيه، ثم تضيف أربعة تسريبات، واحداً في كل مرة. كل تسريب سطرٌ واحد من الشيفرة، قد يكتبه محلّل في يوم عمل عادي. وكل مرحلة تُقيَّم مرّتين: مرة بالتحقّق المتقاطع الخاص بها، ومرة على بيانات خُتمت قبل أن يبدأ أيّ من ذلك.
يجب أن تطابق بصمةُ الشيفرة المطبوعة البصمةَ المعروضة في هذه الصفحة.
import azimuth_nb as azimuth

env = azimuth.setup(SLUG, lang=LANG, profile=PROFILE)التسرّب، على مراحل
Tesla T4 · 14.6 غ.ب · ذاكرة 12.7 غ.ب · PyTorch 2.11.0+cu130
الملف: free
جاهز · dev_patients=800, holdout_patients=1500, visits_mean=3.5, n_markers=400, k_select=20, folds=5, trees=300, alert_rate=0.2, shuffles=3, seed=17
الشيفرة · 4ac5ee59710b85e9البيانات اصطناعية، وُلّدت بحيث يكون الجواب الصحيح معروفاً. لكل مريض هشاشة خفيّة ترفع خطر كل حالة دخول له. هذه الهشاشة ليست عموداً في البيانات، لكنها تجعل زيارات المريض الواحد متشابهة فيما بينها. الإشارة الحقيقية موجودة في ثمانية أعمدة سريرية. وحولها مئات المؤشّرات المخبرية التي لا تحمل أيّ إشارة، كما يحدث في أيّ استخراج واسع من قاعدة بيانات مستشفى.
وهناك عمود آخر يأتي من مستودع البيانات: عدد اتصالات تنسيق الرعاية المسجّلة خلال الثلاثين يوماً التي تلي الخروج. المرضى الذين عادوا إلى المستشفى يتلقّون كثيراً من هذه الاتصالات، لأن عودتهم هي ما يُطلقها. لكن في اللحظة التي يجب أن يقرّر فيها النموذج، لم يحدث أيّ اتصال بعد.
أمّا البيانات المحجوزة فبُنيت كما سيلقى النموذجُ العالمَ فعلاً: سنة لاحقة، ومرضى لم يُرَوا من قبل، وكل عمود بالقيمة التي يحملها لحظة الخروج. نسبة العودة فيها قريبة من نسبتها في بيانات التطوير (35.400٪ مقابل 38.200٪). العالم لا يتغيّر بين الفترتين، وهذا مقصود. فإذا انهار شيء لاحقاً في هذه الورشة، فلا يمكن ردّه إلى انزياح التوزيع.
مجموعتان لا يشترك فيهما أيّ مريض. لاحظ أن عمود ما بعد الخروج موجود في الاثنتين، لكنه صفر في البيانات المحجوزة.
import numpy as np
import pandas as pd

cfg = env.cfg
CLINICAL = ["age", "chronic", "los", "n_meds", "lab_a", "lab_b", "emergency", "prior"]
MARKERS = [f"marker_{i:03d}" for i in range(cfg["n_markers"])]
POST_DISCHARGE = "followup_calls"


def cohort(n_patients, t_start, t_end, rng):
    """Admissions for n_patients over [t_start, t_end) months.

    Each patient carries a hidden frailty that raises the risk of every one of
    their admissions. It is never a column, but it makes one patient's visits
    resemble each other — which is what a careless split will exploit.
    """
    rows = []
    for pid in range(n_patients):
        frailty = rng.normal()
        age = rng.normal(65, 12)
        chronic = max(0.0, rng.normal(2 + 0.8 * frailty, 1.2))
        n_visits = 1 + rng.poisson(cfg["visits_mean"])
        times = np.sort(rng.uniform(t_start, t_end, n_visits))
        for j, t in enumerate(times):
            los = rng.gamma(2, 2 + 0.5 * max(frailty, -1.5))
            n_meds = rng.poisson(5 + chronic)
            lab_a = rng.normal(0.4 * frailty, 1)
            lab_b = rng.normal(0, 1)
            emergency = float(rng.random() < 0.3 + 0.1 * (frailty > 0))
            logit = (
                -1.3
                + 1.5 * frailty
                + 0.25 * (chronic - 2)
                + 0.12 * (los - 5)
                + 0.4 * emergency
                + 0.3 * lab_a
                + 0.15 * j
                + 0.01 * (age - 65)
            )
            readmitted = int(rng.random() < 1 / (1 + np.exp(-logit)))
            rows.append(
                {
                    "patient": pid,
                    "month": t,
                    "age": age,
                    "chronic": chronic,
                    "los": los,
                    "n_meds": n_meds,
                    "lab_a": lab_a,
                    "lab_b": lab_b,
                    "emergency": emergency,
                    "prior": float(j),
                    "readmitted": readmitted,
                }
            )
    df = pd.DataFrame(rows)
    for col in ["lab_a", "lab_b"]:  # labs are not always drawn
        df.loc[rng.random(len(df)) < 0.2, col] = np.nan
    markers = pd.DataFrame(rng.normal(size=(len(df), len(MARKERS))), columns=MARKERS)
    return pd.concat([df, markers], axis=1)


rng = np.random.default_rng(cfg["seed"])
dev = cohort(cfg["dev_patients"], 0, 24, rng)
holdout = cohort(cfg["holdout_patients"], 24, 36, rng)
holdout["patient"] += 1_000_000  # new people, not new visits by old ones

# The warehouse also holds care-coordination calls logged in the 30 days AFTER
# discharge. Readmitted patients get many of them, because the readmission is
# what triggers the calls. At the moment the model must decide, none have
# happened yet — so in the holdout, built as the model will meet the world,
# the column is zero.
dev[POST_DISCHARGE] = rng.poisson(0.2 + 1.5 * dev["readmitted"]).astype(float)
holdout[POST_DISCHARGE] = 0.0

y_dev = dev["readmitted"].to_numpy()
y_holdout = holdout["readmitted"].to_numpy()
groups = dev["patient"].to_numpy()

# Captured values are rounded where they are made, so the page quotes the
# same digits the notebook prints.
dev_rate_pct = round(100 * y_dev.mean(), 1)
holdout_rate_pct = round(100 * y_holdout.mean(), 1)
dev_admissions = len(dev)
holdout_admissions = len(holdout)

if env.lang == "ar":
    # Counts go after a colon: Arabic number-noun agreement depends on the
    # number, and these numbers come from the profile.
    print(
        f"التطوير — الأشهر 0–24 | المرضى: {cfg['dev_patients']} | "
        f"حالات الدخول: {dev_admissions} | نسبة العودة: {dev_rate_pct}٪"
    )
    print(
        f"البيانات المحجوزة — الأشهر 24–36 | مرضى جدد: {cfg['holdout_patients']} | "
        f"حالات الدخول: {holdout_admissions} | نسبة العودة: {holdout_rate_pct}٪"
    )
    print(
        f"الأعمدة — سريرية: {len(CLINICAL)} | مؤشّرات مخبرية: {len(MARKERS)} | "
        f"بعد الخروج: {POST_DISCHARGE}"
    )
else:
    print(
        f"development: {dev_admissions} admissions from {cfg['dev_patients']} patients, "
        f"months 0-24, readmission rate {dev_rate_pct}%"
    )
    print(
        f"holdout:     {holdout_admissions} admissions from {cfg['holdout_patients']} new "
        f"patients, months 24-36, readmission rate {holdout_rate_pct}%"
    )
    print(
        f"columns: {len(CLINICAL)} clinical, {len(MARKERS)} lab markers, "
        f"and one post-discharge field ({POST_DISCHARGE})"
)التطوير — الأشهر 0–24 | المرضى: 800 | حالات الدخول: 3562 | نسبة العودة: 38.2٪
البيانات المحجوزة — الأشهر 24–36 | مرضى جدد: 1500 | حالات الدخول: 6736 | نسبة العودة: 35.4٪
الأعمدة — سريرية: 8 | مؤشّرات مخبرية: 400 | بعد الخروج: followup_callsيتبع البروتوكول النزيه قاعدتين. الأولى: كل خطوة تتعلّم من البيانات توضع داخل خط معالجة (pipeline). والمقصود هنا تعويض القيم الناقصة، وتوحيد المقاييس، واختيار 20 ميزة. بهذا يُعاد ملاءمة كل خطوة داخل كل طيّة تدريب، فلا ترى أبداً الطيّة التي ستُقيَّم عليها. القاعدة الثانية: تُقسَّم الطيّات حسب المريض. فالنموذج سيلقى بعد إطلاقه مرضى جدداً، والتقييم يجب أن يفعل الشيء نفسه.
الدالّة نفسها تُنتج كل المراحل. وكل تسريب فرعٌ واحد من نوع if، مُعلَّم بالكلمة LEAK في الشيفرة، فترى بالضبط أيّ سطر يتغيّر.
انظر إلى الفرق، لا إلى قيمة AUC. التقدير النزيه ليس بالضرورة تقديراً مرتفعاً. إنه التقدير الذي تؤكّده البيانات المحجوزة.
import warnings

from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.impute import SimpleImputer
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import GroupKFold, KFold, cross_val_predict
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

warnings.filterwarnings("ignore", message="The groups parameter is ignored")

STAGES = {
    0: "honest",
    1: "+ scale before split",
    2: "+ select before split",
    3: "+ split rows, not patients",
    4: "+ post-discharge column",
}
if env.lang == "ar":
    STAGES = {
        0: "نزيه",
        1: "+ توحيد قبل التقسيم",
        2: "+ انتقاء قبل التقسيم",
        3: "+ تقسيم الزيارات لا المرضى",
        4: "+ عمود ما بعد الخروج",
    }


def boosted():
    return HistGradientBoostingClassifier(
        max_iter=cfg["trees"], learning_rate=0.05, random_state=cfg["seed"]
    )


def evaluate(stage, labels=None, make_model=boosted):
    """Score one protocol by its own cross-validation, then on the holdout.

    Leaks are cumulative: stage 3 carries the leaks of stages 1 and 2. Each one
    is a single line below, and each line is one an analyst might write.
    """
    y = y_dev if labels is None else labels
    cols = CLINICAL + MARKERS
    if stage >= 4:
        cols = [*cols, POST_DISCHARGE]  # LEAK 4: a field that is filled in later
    X, X_out = dev[cols].to_numpy(), holdout[cols].to_numpy()

    steps = []
    if stage >= 1:  # LEAK 1: impute and scale using every development row
        imputer, scaler = SimpleImputer(), StandardScaler()
        X = scaler.fit_transform(imputer.fit_transform(X))
        X_out = scaler.transform(imputer.transform(X_out))
    else:
        steps += [SimpleImputer(), StandardScaler()]

    if stage >= 2:  # LEAK 2: choose features by their link to the label, on every row
        keep = SelectKBest(f_classif, k=cfg["k_select"]).fit(X, y).get_support()
        if stage >= 4:
            keep[-1] = True  # the analyst keeps the field; it ranks first anyway
        X, X_out = X[:, keep], X_out[:, keep]
    else:
        steps += [SelectKBest(f_classif, k=cfg["k_select"])]

    if stage >= 3:  # LEAK 3: shuffle admissions, so a patient lands on both sides
        splitter = KFold(cfg["folds"], shuffle=True, random_state=cfg["seed"])
    else:
        splitter = GroupKFold(cfg["folds"])

    model = make_pipeline(*steps, make_model())
    oof = cross_val_predict(model, X, y, cv=splitter, groups=groups, method="predict_proba")[:, 1]
    # The care team can call one patient in five: the threshold is set on the
    # cross-validated scores, exactly as it would be before launch.
    threshold = np.quantile(oof, 1 - cfg["alert_rate"])

    model.fit(X, y)
    p_out = model.predict_proba(X_out)[:, 1]
    return {
        "cv_auc": roc_auc_score(y, oof),
        "holdout_auc": roc_auc_score(y_holdout, p_out),
        "cv_recall": (oof[y == 1] >= threshold).mean(),
        "holdout_recall": (p_out[y_holdout == 1] >= threshold).mean(),
        "holdout_flagged": (p_out >= threshold).mean(),
        "p_out": p_out,
    }


honest = evaluate(0)
cv_auc_honest = round(honest["cv_auc"], 3)
holdout_auc_honest = round(honest["holdout_auc"], 3)
honest_gap = round(honest["cv_auc"] - honest["holdout_auc"], 3)

if env.lang == "ar":
    print(f"التقييم النزيه — AUC بالتحقّق المتقاطع: {cv_auc_honest:.3f}")
    print(f"                  AUC على البيانات المحجوزة: {holdout_auc_honest:.3f}")
    print(f"                  الفرق: {honest_gap:+.3f}")
else:
    print(f"honest protocol — cross-validated AUC: {cv_auc_honest:.3f}")
    print(f"                  holdout AUC:         {holdout_auc_honest:.3f}")
print(f" gap: {honest_gap:+.3f}")التقييم النزيه — AUC بالتحقّق المتقاطع: 0.749
AUC على البيانات المحجوزة: 0.749
الفرق: -0.001أعطى التحقّق المتقاطع 0.749، وأعطت البيانات المحجوزة 0.749، والفرق بينهما -0.001. هذا التطابق هو الغرض من خط الأساس كله. فهو يثبت أن هذه البيانات قابلة لتقييم نزيه. لذلك فإن أيّ فرق يظهر من الآن فصاعداً سببه تسريب، لا البيانات نفسها.
التسريبات تراكمية: كل مرحلة تحتفظ بتسريبات ما قبلها.
- التوحيد قبل التقسيم. يُلاءَم تعويض القيم الناقصة وتوحيد المقاييس على كل صفوف التطوير، ثم يجري التحقّق المتقاطع على البيانات بعد تحويلها.
- الانتقاء قبل التقسيم. تُختار الميزات الأكثر ارتباطاً بالتسمية، وعددها 20، باستخدام كل الصفوف. ويشمل ذلك الصفوف التي ستُقيَّم عليها كل طيّة لاحقاً.
- تقسيم الزيارات لا المرضى. تُخلط حالات الدخول في الطيّات عشوائياً، فيظهر المريض نفسه على جانبي التقسيم.
- إبقاء عمود ما بعد الخروج. يحتلّ هذا العمود المرتبة الأولى في انتقاء الميزات، فيُبقيه المحلّل.
توقّع قبل التشغيل: أيّ التسريبات الأربعة سيرفع درجة التحقّق المتقاطع أكثر من غيره؟ وأيّها سيضرّ الأداء على البيانات المحجوزة؟
خطّان، لكل سؤال خطّ. البرتقالي هو ما ادّعاه كل بروتوكول. والأزرق هو ما فعله نموذجه في السنة المحجوزة. يبدأ المحور من 0.5 لأنها قيمة رمي قطعة نقود.
results = {0: honest}
for stage in range(1, 5):
    results[stage] = evaluate(stage)

header = (
    ("المرحلة", "AUC تحقّق", "AUC محجوزة", "الفرق")
    if env.lang == "ar"
    else ("stage", "CV AUC", "holdout AUC", "gap")
)
print(f"{header[0]:<30}{header[1]:>12}{header[2]:>14}{header[3]:>9}")
for stage, r in results.items():
    print(
        f"{stage} {STAGES[stage]:<28}{r['cv_auc']:>12.3f}{r['holdout_auc']:>14.3f}"
        f"{r['cv_auc'] - r['holdout_auc']:>+9.3f}"
    )

cv_auc_leaky = round(results[4]["cv_auc"], 3)
holdout_auc_leaky = round(results[4]["holdout_auc"], 3)
leaky_gap = round(results[4]["cv_auc"] - results[4]["holdout_auc"], 3)
cv_auc_stage3 = round(results[3]["cv_auc"], 3)
cv_gain_stage1 = round(results[1]["cv_auc"] - results[0]["cv_auc"], 3)
cv_gain_stage2 = round(results[2]["cv_auc"] - results[1]["cv_auc"], 3)
cv_gain_stage3 = round(results[3]["cv_auc"] - results[2]["cv_auc"], 3)
cv_gain_stage4 = round(results[4]["cv_auc"] - results[3]["cv_auc"], 3)
holdout_drop_leaky = round(results[0]["holdout_auc"] - results[4]["holdout_auc"], 3)

import matplotlib.pyplot as plt
from matplotlib import font_manager


def ar(text):
    """Shape and order Arabic for matplotlib, which draws isolated glyphs in
    logical order. A no-op in the English build."""
    if env.lang != "ar":
        return text
    import arabic_reshaper
    from bidi.algorithm import get_display

    # Line by line: the bidi pass would otherwise reorder whole lines.
    return "\n".join(get_display(arabic_reshaper.reshape(line)) for line in text.split("\n"))


if env.lang == "ar":
    from pathlib import Path

    # matplotlib's bundled DejaVu has no Arabic glyphs. Amiri comes from the
    # apt line in the dependencies cell; Ubuntu releases name the file
    # differently, so match case-insensitively.
    amiri = [
        p for p in Path("/usr/share/fonts").rglob("*.ttf") if p.name.lower() == "amiri-regular.ttf"
    ]
    if amiri:
        font_manager.fontManager.addfont(str(amiri[0]))
        plt.rcParams["font.family"] = font_manager.FontProperties(fname=str(amiri[0])).get_name()
    else:
        print("تنبيه: لم يُعثر على خطّ Amiri؛ ستظهر النصوص العربية في الرسوم مربّعات فارغة.")

stages = list(results)
fig, ax = plt.subplots(figsize=(7.5, 4.2))
ax.plot(
    stages,
    [results[s]["cv_auc"] for s in stages],
    "o-",
    color="#c2410c",
    lw=2,
    label=ar("ما قاله التحقّق المتقاطع") if env.lang == "ar" else "what cross-validation said",
)
ax.plot(
    stages,
    [results[s]["holdout_auc"] for s in stages],
    "o-",
    color="#1d4ed8",
    lw=2,
    label=ar("ما حدث على بيانات لم تُرَ") if env.lang == "ar" else "what happened on unseen data",
)
# AUC's floor is 0.5, not 0: a coin flip. Anchoring there keeps "flat" honest.
ax.set_ylim(0.5, 1.0)
ax.axhline(0.5, color="#999", lw=0.8)
ax.set_xticks(stages)
if env.lang == "ar":
    ax.set_xticklabels(
        [
            ar(s)
            for s in [
                "نزيه",
                "+ توحيد\nقبل التقسيم",
                "+ انتقاء\nقبل التقسيم",
                "+ تقسيم الزيارات\nلا المرضى",
                "+ عمود\nبعد الخروج",
            ]
        ]
    )
    ax.set_ylabel("AUC")
    ax.set_title(ar("كل تسريب يرفع الدرجة المُعلنة، ولا يرفع الأداء الحقيقي"))
else:
    ax.set_xticklabels(
        [
            "honest",
            "+ scale\nbefore split",
            "+ select\nbefore split",
            "+ split rows,\nnot patients",
            "+ post-discharge\ncolumn",
        ]
    )
    ax.set_ylabel("AUC")
    ax.set_title("Every leak raises the reported score. None raises the real one.")
ax.legend(loc="upper left", frameon=False)
fig.tight_layout()
plt.show()المرحلة AUC تحقّق AUC محجوزة الفرق
0 نزيه 0.749 0.749 -0.001
1 + توحيد قبل التقسيم 0.750 0.749 +0.001
2 + انتقاء قبل التقسيم 0.764 0.749 +0.015
3 + تقسيم الزيارات لا المرضى 0.771 0.749 +0.021
4 + عمود ما بعد الخروج 0.900 0.731 +0.169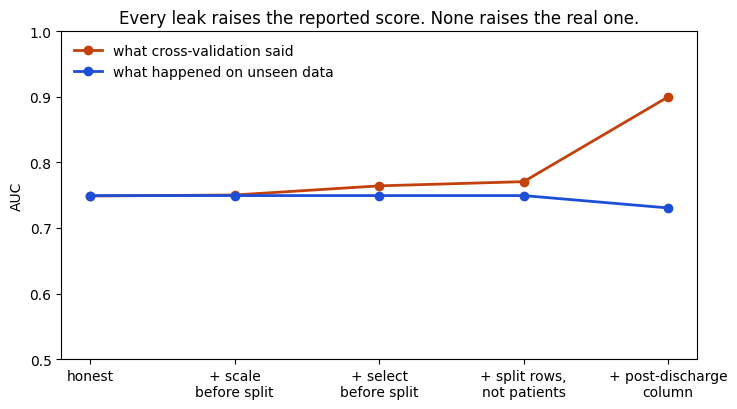
الخط البرتقالي يرتفع في كل مرحلة. أمّا الخط الأزرق فيبقى مستوياً تماماً ثلاث مراحل، ثم ينخفض.
التسريب الذي تحذّر منه الدروس أولاً هو توحيد المقاييس قبل التقسيم. وقد غيّر الدرجة بمقدار 0.002 فقط. السبب أن نماذج الأشجار تقسم البيانات حسب ترتيب القيم، وتوحيد المقاييس لا يغيّر هذا الترتيب. مع نموذج يعتمد على المسافات قد يكون للسطر نفسه أثر، لذا يبقى إصلاحه مستحقّاً. لكنّ الضرر هنا ليس فيه.
انتقاء الميزات على كل الصفوف أضاف 0.014. فبين 400 مؤشّر من الضجيج الخالص، يرتبط بعضها بهذه التسميات بالذات عن طريق المصادفة. والانتقاء يعثر على هذه المؤشّرات تحديداً. وداخل كل طيّة تبدو هذه المؤشّرات تنبّؤية، لأنها اختيرت وتسميات تلك الطيّة معروضة أمام الانتقاء.
تقسيم الزيارات بدل المرضى أضاف 0.006. فالنموذج هنا يقيّم حالات دخول لمرضى سبق أن تدرّب على حالاتهم الأخرى.
عمود ما بعد الخروج أضاف وحده 0.129، ورفع قيمة AUC المُعلنة إلى 0.900. لكنّ النموذج نفسه سجّل 0.731 على السنة المحجوزة، أي أقلّ من النموذج النزيه بمقدار 0.019. البروتوكول صاحب أفضل درجة أطلق أسوأ نموذج.
كل مرحلة من 0 إلى 3 تُنتج نموذجاً للإطلاق. قبل تشغيل هذه الخلية، قرّر مقدار الاختلاف الذي تتوقّعه بين تنبّؤاتها.
# Stages 0 to 3 differ only in how the score was ESTIMATED. The model each one
# would ship is trained on all development rows either way. Compare what those
# four models predict for the holdout patients.
reference = results[0]["p_out"]
same_model_max_diff = float(max(np.abs(results[s]["p_out"] - reference).max() for s in (1, 2, 3)))
cv_inflation_stage3 = round(results[3]["cv_auc"] - results[0]["cv_auc"], 3)

if env.lang == "ar":
    print(f"أكبر فرق بين تنبّؤات المراحل 0–3 على المرضى الجدد: {same_model_max_diff:.2e}")
    print(f"ومع ذلك ارتفع AUC المُعلَن من {cv_auc_honest:.3f} إلى {cv_auc_stage3:.3f}")
else:
    print(f"largest difference in holdout predictions across stages 0-3: {same_model_max_diff:.2e}")
print(f"while the reported AUC rose from {cv_auc_honest:.3f} to {cv_auc_stage3:.3f}")أكبر فرق بين تنبّؤات المراحل 0–3 على المرضى الجدد: 0.00e+00
ومع ذلك ارتفع AUC المُعلَن من 0.749 إلى 0.771أكبر فرق بين تنبّؤات هذه النماذج الأربعة هو 0. أي أنها نموذج واحد.
والسبب أن النموذج الذي تُطلقه يُلاءَم على كل صفوف التطوير، أيّاً كان البروتوكول الذي تتبعه. فالتوحيد والانتقاء على كل الصفوف هو ما يحدث في النهاية على أيّ حال. التسريبات الثلاثة الأولى غيّرت التقدير وحده: ارتفع بمقدار 0.022، ولم يتغيّر النموذج إطلاقاً.
هذا يعطينا نوعين من التسريب. التسريب في التقييم لا يمسّ النموذج، لكنه يُفسد ما تعتقده عنه. والضرر يأتي لاحقاً، عبر قرارات تُبنى على هذا الاعتقاد: أيّ نموذج تُطلق، وأيّ ميزات تُبقي، وأيّ أداء تَعِد به. أمّا التسريب في البيانات فيغيّر النموذج نفسه. وعمود ما بعد الخروج من هذا النوع الثاني. الخلية التالية تُظهر ما يفعله حين يصبح النموذج قيد التشغيل.
درجة الخطر لا تتحوّل إلى فعل إلا عبر عتبة. فريق الرعاية يستطيع الاتصال بـ20٪ من المرضى. لذلك تُوضع العتبة عند النقطة التي تجعل 20٪ من حالات الدخول فوقها، حسب درجات التحقّق المتقاطع. وهكذا تماماً كانت ستُضبط قبل الإطلاق. ثم تُطبَّق العتبة نفسها على السنة المحجوزة.
نسبة الالتقاط (recall) هي حصّة حالات العودة الحقيقية التي يلتقطها التنبيه. قارن كل عمود برتقالي بالعمود الأزرق إلى جانبه.
recall_cv_leaky = round(results[4]["cv_recall"], 3)
recall_holdout_leaky = round(results[4]["holdout_recall"], 3)
recall_cv_honest = round(results[0]["cv_recall"], 3)
recall_holdout_honest = round(results[0]["holdout_recall"], 3)
recall_lost = round(results[0]["holdout_recall"] - results[4]["holdout_recall"], 3)
# Percentages for prose: "caught 0.2% of readmissions" reads; "0.002" does not.
recall_cv_leaky_pct = round(100 * results[4]["cv_recall"], 1)
recall_holdout_leaky_pct = round(100 * results[4]["holdout_recall"], 1)
flagged_holdout_leaky_pct = round(100 * results[4]["holdout_flagged"], 1)
recall_cv_honest_pct = round(100 * results[0]["cv_recall"], 1)
recall_holdout_honest_pct = round(100 * results[0]["holdout_recall"], 1)
alert_rate_pct = round(100 * cfg["alert_rate"])

if env.lang == "ar":
    print(f"{'':<30}{'الالتقاط (تحقّق)':>16}{'الالتقاط بعد الإطلاق':>22}{'نسبة المُنبَّه عليهم':>22}")
else:
    print(f"{'':<30}{'recall (CV)':>14}{'recall (holdout)':>18}{'share alerted':>16}")
for stage in (0, 4):
    r = results[stage]
    print(
        f"{stage} {STAGES[stage]:<28}{r['cv_recall']:>14.1%}{r['holdout_recall']:>18.1%}"
        f"{r['holdout_flagged']:>16.1%}"
    )

fig, ax = plt.subplots(figsize=(6.5, 3.6))
x = np.arange(2)
cv_bars = [recall_cv_honest, recall_cv_leaky]
out_bars = [recall_holdout_honest, recall_holdout_leaky]
ax.bar(
    x - 0.18,
    cv_bars,
    0.36,
    color="#c2410c",
    label=ar("في التحقّق المتقاطع") if env.lang == "ar" else "in cross-validation",
)
ax.bar(
    x + 0.18,
    out_bars,
    0.36,
    color="#1d4ed8",
    label=ar("بعد الإطلاق") if env.lang == "ar" else "after launch",
)
ax.set_ylim(0, 1)  # recall starts at zero, and zero is part of the story
ax.set_xticks(x)
if env.lang == "ar":
    ax.set_xticklabels([ar("نزيه"), ar("مع العمود المُسرَّب")])
    ax.set_ylabel(ar("نسبة حالات العودة التي التُقطت"))
    ax.set_title(ar("العتبة نفسها، بعد الإطلاق"))
else:
    ax.set_xticklabels(["honest", "with the leaked column"])
    ax.set_ylabel("share of readmissions caught")
    ax.set_title("The same threshold, after launch")
ax.legend(frameon=False)
fig.tight_layout()
plt.show() الالتقاط (تحقّق) الالتقاط بعد الإطلاق نسبة المُنبَّه عليهم
0 نزيه 36.1% 32.3% 16.8%
4 + عمود ما بعد الخروج 49.2% 0.2% 0.1%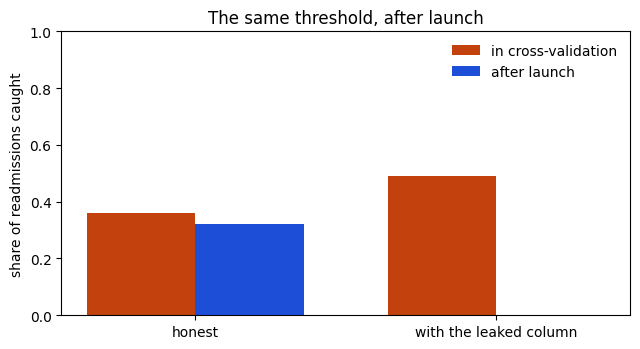
في التحقّق المتقاطع، التقط النموذج المُسرِّب 49.200٪ من حالات العودة. هذا أكثر من النموذج النزيه، الذي التقط 36.100٪. لكنه بعد الإطلاق التقط 0.200٪ فقط، ولم يُنبّه إلا على 0.100٪ من المرضى. أمّا النموذج النزيه فبقي يلتقط 32.300٪.
هذا هو الجزء الذي لم يُظهره مقياس AUC. فهذا المقياس يطرح سؤالاً واحداً: هل رُتّب المرضى العائدون فوق غيرهم؟ والنموذج المُسرِّب ما زال يرتّبهم بشكل شبه جيّد. لهذا انخفضت قيمته على البيانات المحجوزة بمقدار 0.019 فقط.
الذي تغيّر هو مستوى الدرجات كلها. تعلّم النموذج أن الاتصالات بعد الخروج تعني خطراً. ولحظةَ الخروج، عدد الاتصالات صفر عند كل المرضى. لذلك انخفضت كل الدرجات. أمّا العتبة فضُبطت على درجات كان العمود فيها ممتلئاً، فصارت الآن فوق كل الدرجات تقريباً.
في لوحة المتابعة، يبدو هذا انخفاضاً صغيراً في AUC. أمّا في جناح المستشفى، فقد صمت التنبيه.
عائلة نماذج مختلفة، والبروتوكولان أنفسهما. انظر: هل تتبع الفروقُ النموذجَ أم البروتوكول؟
# Is this a property of gradient boosting? Swap in a random forest and repeat
# the two ends of the ladder.
from sklearn.ensemble import RandomForestClassifier


def forest():
    return RandomForestClassifier(n_estimators=cfg["trees"], n_jobs=-1, random_state=cfg["seed"])


rf_honest = evaluate(0, make_model=forest)
rf_leaky = evaluate(4, make_model=forest)
rf_gap_honest = round(rf_honest["cv_auc"] - rf_honest["holdout_auc"], 3)
rf_gap_leaky = round(rf_leaky["cv_auc"] - rf_leaky["holdout_auc"], 3)
rf_cv_auc_leaky = round(rf_leaky["cv_auc"], 3)
rf_recall_holdout_leaky_pct = round(100 * rf_leaky["holdout_recall"], 1)

if env.lang == "ar":
    print(f"{'غابة عشوائية':<30}{'AUC تحقّق':>12}{'AUC محجوزة':>14}{'الالتقاط بعد الإطلاق':>22}")
else:
    print(f"{'random forest':<30}{'CV AUC':>12}{'holdout AUC':>14}{'recall after launch':>22}")
for stage, r in ((0, rf_honest), (4, rf_leaky)):
    print(
        f"{stage} {STAGES[stage]:<28}{r['cv_auc']:>12.3f}{r['holdout_auc']:>14.3f}"
        f"{r['holdout_recall']:>22.1%}"
)غابة عشوائية AUC تحقّق AUC محجوزة الالتقاط بعد الإطلاق
0 نزيه 0.765 0.761 34.9%
4 + عمود ما بعد الخروج 0.908 0.748 0.0%الغابة العشوائية تكرّر النمط نفسه. الفرق في بروتوكولها النزيه 0.003، وفي بروتوكولها المُسرِّب 0.160. وقيمة AUC بالتحقّق المتقاطع 0.908، أمّا نسبة الالتقاط بعد الإطلاق فهي 0٪. تغيير النموذج لا يزيل التسريب، لأن التسريب في التقييم وفي البيانات، لا في خوارزمية التعلّم.
في الغالب لن تملك سنةً مستقبلية مختومة. لكن هناك اختباراً رخيصاً لا يحتاج إلى بيانات إضافية: اخلط التسميات عشوائياً، ثم أعد تشغيل البروتوكول كاملاً. بعد الخلط لا يبقى شيء يمكن التنبّؤ به. لذلك يجب أن يسجّل البروتوكول النزيه قرابة 0.5. وإذا جاءت الدرجة فوق ذلك بثبات، فمصدرها الإجراء نفسه، لا ما تعلّمه النموذج من المرضى. وتأخذ الخلية متوسّط 3 عمليات خلط لكل مرحلة.
يجب أن يقترب العمود الأول من 0.5. قارن المرحلة 2 بالمرحلة 4: قيمتا AUC المُعلنتان لهما متباعدتان كثيراً.
# A cheap test anyone can run: destroy the labels, rerun the WHOLE protocol.
# With no signal left, an honest protocol must score about 0.5. Anything
# reliably above it was learned from the procedure, not from the patients.
audit = {}
for stage in STAGES:
    scores = []
    for k in range(cfg["shuffles"]):
        shuffled = np.random.default_rng(cfg["seed"] + 100 + k).permutation(y_dev)
        scores.append(evaluate(stage, labels=shuffled)["cv_auc"])
    audit[stage] = float(np.mean(scores))

head = (
    ("المرحلة", "AUC على تسميات مخلوطة", "AUC المُعلَن")
    if env.lang == "ar"
    else ("stage", "AUC on shuffled labels", "reported AUC")
)
print(f"{head[0]:<30}{head[1]:>24}{head[2]:>22}")
for stage in STAGES:
    print(f"{stage} {STAGES[stage]:<28}{audit[stage]:>24.3f}{results[stage]['cv_auc']:>22.3f}")

audit_auc_honest = round(audit[0], 3)
audit_auc_stage2 = round(audit[2], 3)
audit_auc_leaky = round(audit[4], 3)المرحلة AUC على تسميات مخلوطة AUC المُعلَن
0 نزيه 0.496 0.749
1 + توحيد قبل التقسيم 0.496 0.750
2 + انتقاء قبل التقسيم 0.531 0.764
3 + تقسيم الزيارات لا المرضى 0.526 0.771
4 + عمود ما بعد الخروج 0.527 0.900سجّل البروتوكول النزيه 0.496 على التسميات المخلوطة، كما ينبغي. أمّا الانتقاء قبل التقسيم فرفع هذه القيمة إلى 0.531. أي أن الإجراء وجد إشارة في الضجيج، والتدقيق كشف ذلك.
المرحلة 4 سجّلت 0.527، أي قرابة ما سجّلته المرحلة 2. التدقيق لم يرَ عمود ما بعد الخروج، مع أن هذا العمود أضاف 0.129 إلى قيمة AUC المُعلنة. السبب أن العمود ينسخ النتائج الحقيقية. وبعد خلط التسميات لم يعد العمود يطابقها، فلم يبقَ لديه ما يسرّبه.
وخلط الصفوف يخفي أيضاً تداخل المرضى في المرحلة 3. فالتسميات المخلوطة لم تعد تنتمي إلى مرضاها. وأيّ تدقيق لهذا التسريب يجب أن يُبقي تسميات كل مريض معاً أثناء الخلط.
إذن، تدقيق الخلط يختبر الإجراء. أمّا اختبار الأعمدة فيحتاج إلى فحص آخر.
تمرين
يقيّم هذا الفحص كل عمود وحده مقابل التسمية، ويعلّم كل عمود تتجاوز درجته قيمة SUSPICIOUS_AUC. شغّله أولاً كما هو. ثم اخفض العتبة حتى يُعلَّم عمود ثانٍ. هل هذا العمود تسريب؟ ما الذي تحتاج إلى معرفته عن كل عمود مُعلَّم كي تقرّر؟ وأين ستجد هذه المعلومة؟
# YOUR TURN.
#
# The shuffle audit tests the procedure. This screen tests the columns: score
# each one ALONE against the label. A single field that nearly matches the
# whole model is a question to ask whoever owns that field, not a gift.
SUSPICIOUS_AUC = 0.80

solo = {}
for col in CLINICAL + MARKERS + [POST_DISCHARGE]:
    values = dev[col].fillna(dev[col].median()).to_numpy()
    a = roc_auc_score(y_dev, values)
    solo[col] = max(a, 1 - a)  # direction does not matter for a screen

ranked = sorted(solo.items(), key=lambda kv: kv[1], reverse=True)
for col, score in ranked[:8]:
    flag = (
        "  <-- " + ("اسأل عنه" if env.lang == "ar" else "ask about it")
        if score >= SUSPICIOUS_AUC
        else ""
    )
    print(f"{col:<18}{score:.3f}{flag}")

solo_auc_post_discharge = round(solo[POST_DISCHARGE], 3)
solo_auc_best_clinical = round(max(solo[c] for c in CLINICAL), 3)
solo_auc_best_marker = round(max(solo[c] for c in MARKERS), 3)يتوفّر تلميح في الدفتر — env.hint(1)
سجّل عمود ما بعد الخروج وحده 0.846، أي أكثر من النموذج النزيه كاملاً (0.749). وحقل واحد يتفوّق على النموذج كله هو أوضح تحذير يمكن أن تعطيه مجموعة بيانات. للمقارنة، سجّل أفضل عمود سريري 0.738، وسجّل أفضل مؤشّر بين مؤشّرات الضجيج الـ400 0.532.
لكنّ الرقم وحده لا يحسم المسألة. فقد تسجّل ميزة مشروعة قوية وتسريبٌ درجتين متقاربتين. ما يحسمها حقيقة من خارج البيانات: متى يُكتب كل حقل، مقارنةً بلحظة اتخاذ القرار. كل عمود يحتاج إلى هذا الطابع الزمني. والعثور عليه يعني عادةً سؤال الأشخاص المسؤولين عن الحقل.
يأتي فحص النموذج المرجعي أولاً. فلو لم يتعلّم النموذج النزيه شيئاً، لفقدت كل مقارنة بعده معناها.
# The control first: if the honest model never learned to rank patients, every
# comparison below is a comparison against nothing.
honest_learns_ok = env.check("honest-model-learns", holdout_auc_honest)
honest_gap_ok = env.check("honest-cv-tracks-holdout", honest_gap)
recall_lost_ok = env.check("leak-costs-recall", recall_lost)✓ النموذج النزيه: قيمة AUC على حالات دخول لمرضى جدد: 0.749 (المطلوب ≥ 0.68)
✓ البروتوكول النزيه: قيمة AUC بالتحقّق المتقاطع ناقص قيمتها على البيانات المحجوزة: -0.001 (المطلوب ≥ -0.05 و≤ 0.05)
✓ حالات العودة الملتقطة بعد الإطلاق: النموذج النزيه ناقص النموذج المُسرِّب: 0.321 (المطلوب ≥ 0.2)كل تسريب في هذه الورشة رفع الدرجة المُعلنة، ولم يحسّن أيٌّ منها النموذج. هذا هو الشكل الذي يتّخذه التسرّب في العمل الفعلي. نادراً ما يبدو خطأً برمجياً. إنه يبدو أفضل نتيجة حتى الآن.
التقييم نظام قائم بذاته، ويحتاج إلى العناية نفسها التي يحتاجها النموذج:
- قسّم البيانات حسب ما سيكون جديداً بعد الإطلاق. هنا كان ذلك المرضى والزمن. وفي مشروع آخر قد يكون العملاء أو المواقع أو الأجهزة.
- ضع كل خطوة تتعلّم من البيانات داخل خط المعالجة، كي يُعاد ملاءمتها في كل طيّة.
- أعطِ كل عمود طابعاً زمنياً، وقارنه بلحظة القرار.
- اختم مجموعة محجوزة تُبنى كما سيقدّم العالم البيانات فعلاً، وافتحها مرة واحدة.
- اخلط التسميات لتختبر الإجراء، وافحص الأعمدة واحداً واحداً لتختبر البيانات.
- افحص القرار، لا الترتيب وحده. قيمة AUC هنا بالكاد تحرّكت، بينما توقّف التنبيه عن العمل.
receipt = env.receipt()اكتملت الورشة.
رمز الإتمام: AZ-██████████
الصقه في صفحة الورشة على أزيموث لتسجيل إتمامها.مصطلحات هذه الورشة
- التحقق المتقاطع من الأداءCross-Validation
- فرط التخصيصOverfitting
- التعميمGeneralization
- المعيار المرجعيBenchmark