العقول والحياةintermediateمعالج رسوميات~55 دقيقةColab
خلايا الشبكة: نمطٌ سداسي لم يطلبه أحد
Grid Cells From a Network That Was Never Asked
تمثيلٌ لم يطلبه أحد، لكنه جوابٌ عن سؤالٍ طرحناه نحن
فأرٌ في الظلام ما زال يعرف أين هو. يشعر بسرعته وبانعطافاته، ويجمعها أولاً بأول، وهذا ما نسميه . في عام 2005 سجّل الباحثون نشاط الخلايا في القشرة الشمية الداخلية للفأر، فوجدوا خلايا تنشط عند رؤوس نمطٍ مثلثي يمتد على أرض الغرفة كلها. سُمّيت هذه الخلايا خلايا الشبكة، مع أنه لا شيء في عالم الفأر سداسي الشكل. في هذه الورشة تعطي شبكةً تكرارية صغيرة المسألة نفسها: تدخلها السرعة، ويخرج منها جواب «أين أنا؟». ولا ذكر للسداسيات في أي مكان. ثم تفتح النموذج وترسم أين تنشط كل وحدة مخفية فيه. وتدرّب إلى جانبه توأماً لا يختلف عنه إلا في تفصيل واحد، لتعرف ما الذي استدعى السداسيات فعلاً.
الهدف
تتعلم الشبكتان كلتاهما تتبّع موقعهما من السرعة وحدها، لكن شبكة المركز والمحيط تفعل ذلك بدقة أقل. ومع هذا تبقى درجات السداسية لديها، في مجملها، أعلى من درجات توأمها الغاوسي. وفي البذرة العشوائية المستخدمة هنا تتحول حصةٌ واضحة من وحداتها إلى خرائط سداسية مستقرة. وعبر سبع بذور تراوحت هذه الحصة بين 1% و22%: الميل نحو النمط ثبت عبرها كلها، أما النمط نفسه فلم يثبت.
يفتح Colab نسخة للقراءة فقط. احفظ نسخة في Drive للاحتفاظ بتعديلاتك.
يحتاج الدفتر إلى لوحة مفاتيح — يُفضَّل فتحه على حاسوب مكتبي.
الأوراق وراء هذه الورشة
أغمض عينيك، وامشِ ثلاث خطوات إلى الأمام، ثم انعطف يساراً وامشِ خطوتين. ستظل تعرف تقريباً أين الباب. لم يخبرك أحد؛ أنت جمعت حركتك بنفسك، وهذا هو تكامل المسار. الحيوانات تفعل هذا طوال الوقت. وفي القشرة الشمية الداخلية للفأر، تحمل بعض الخلايا المشاركة في هذه العملية بصمةً مدهشة. ارسم نشاط الواحدة منها على أرض الغرفة، تجدها تنشط عند رؤوس نمطٍ مثلثي يغطي الأرض كلها. وحول كل رأس في هذا النمط ستة رؤوس مجاورة، ولهذا نصفه بأنه سداسي، ونسمّي هذه الخلايا .
تسأل هذه الورشة أولاً: إذا أعطينا شبكةً اصطناعية المسألة نفسها ولا شيء غيرها، هل تصل إلى الجواب نفسه؟ ثم تسأل السؤال الأصعب: ما الذي دفعها إليه بالضبط؟
تأكد من ملف التشغيل المختار ومن بصمة الشيفرة؛ فكل ما يلي يأخذ أحجامه من هذا الملف.
import azimuth_nb as azimuth

env = azimuth.setup(SLUG, lang=LANG, profile=PROFILE)خلايا الشبكة: نمطٌ سداسي لم يطلبه أحد
Tesla T4 · 14.6 غ.ب · ذاكرة 12.7 غ.ب · PyTorch 2.11.0+cu128
الملف: free
جاهز · seed=17, box_m=2.2, place_cells=512, place_sigma_m=0.12, surround_scale=2, hidden_units=4096, seq_len=20, batch=200, train_steps=30000, learning_rate=0.0001, weight_decay=0.0001, log_every=2000, map_res=20, eval_batches=25, grid_score_cut=0.3, stability_min=0.5, ring_max=0.7, units_shown=25
الشيفرة · e249e89f5ca00d87مخرج الشبكة ليس زوجاً من الإحداثيات. إنها تتنبأ بنشاط 512 محاكاة، موزعة داخل صندوق طول ضلعه 2.2 متر، وكل خلية تبلغ ذروة نشاطها قرب مركزها. ندرّب نسختين لا تختلفان إلا في شكل هذه الاستجابة. في الأولى، استجابة خلية المكان قمةٌ غاوسية بسيطة. وفي الثانية، تحيط بالقمة حلقةٌ ضحلة من الكبح، وهذا ما نسميه شكل «المركز والمحيط». نحصل عليه بأن نطرح من القمة قمةً غاوسية أعرض منها، أي أنه . المسارات والأوزان الابتدائية وبنية الشبكة وجدول التدريب كلها متطابقة. تمسّك بهذا الاختلاف الوحيد، فبقية الورشة تدور حوله.
في اللوحة اليسرى ستة مسارات محاكاة فوق مراكز خلايا المكان (النقاط الرمادية)؛ وحين يبلغ المسار جداراً يبطئ وينزلق بمحاذاته. وفي اللوحة اليمنى نشاط خلية مكان واحدة على خط يمر بمركزها: البرتقالي لشكل المركز والمحيط، والأزرق للشكل الغاوسي. المنحنى البرتقالي لا ينزل تحت الصفر أبداً، بل يستقر على أرضية مرتفعة، ثم ينخفض إلى الصفر في حلقة حول القمة، وهذه الحلقة هي المحيط. فالشيفرة يجب أن تبقى غير سالبة وأن يكون مجموعها واحداً، ولهذا تشغل الأرضية شبه المسطحة نحو ثلاثة أرباعها. وهذه الأرضية تكاد تكون واحدة أينما كان الموقع، فلا تحمل معلومة عن المكان. لذلك لن تتحرك خسارة هذه الشبكة إلا قليلاً، حتى وهي تتعلم.
import math

import matplotlib.pyplot as plt
import numpy as np
import torch

assert torch.__version__, "torch comes with the runtime; it is never installed here"
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
cfg = env.cfg
BOX = cfg["box_m"]
DT = 0.02  # seconds per step
torch.manual_seed(cfg["seed"])

# One fixed set of place-cell centres, shared by both networks.
centers = (
    torch.rand(cfg["place_cells"], 2, generator=torch.Generator().manual_seed(cfg["seed"])) - 0.5
) * BOX
centers = centers.to(device)


def make_trajectories(rng, batch, steps, box=BOX):
    """Smooth random walks that turn away from walls. Returns positions (batch, steps+1, 2)."""
    sigma_turn = 11.52  # rad/s, rotational velocity spread
    speed_scale = 0.13 * 2 * math.pi  # m/s, Rayleigh scale of forward speed
    border = 0.03
    pos = np.zeros((batch, steps + 1, 2))
    pos[:, 0] = rng.uniform(-box / 2, box / 2, (batch, 2))
    heading = rng.uniform(0, 2 * math.pi, batch)
    turns = rng.normal(0, sigma_turn, (batch, steps))
    speeds = rng.rayleigh(speed_scale, (batch, steps))
    for t in range(steps):
        x, y = pos[:, t, 0], pos[:, t, 1]
        dists = np.stack([box / 2 - x, box / 2 - y, box / 2 + x, box / 2 + y])
        wall_angle = dists.argmin(0) * math.pi / 2
        toward = np.mod(heading - wall_angle + math.pi, 2 * math.pi) - math.pi
        near = (dists.min(0) < border) & (np.abs(toward) < math.pi / 2)
        v = np.where(near, 0.25, 1.0) * speeds[:, t]
        heading = (
            heading
            + np.where(near, np.sign(toward) * (math.pi / 2 - np.abs(toward)), 0.0)
            + DT * turns[:, t]
        )
        pos[:, t + 1] = pos[:, t] + (v * DT)[:, None] * np.stack(
            [np.cos(heading), np.sin(heading)], -1
        )
    return pos


def place_code(pos, surround):
    """Population activity of the place cells at positions (..., 2). Sums to 1 over cells.

    surround=None gives plain Gaussian bumps. surround=s subtracts a wider bump
    (variance scaled by s): a centre that excites, ringed by a zone that inhibits.
    """
    d2 = ((pos[..., None, :] - centers) ** 2).sum(-1)
    width2 = cfg["place_sigma_m"] ** 2
    out = torch.softmax(-d2 / (2 * width2), -1)
    if surround is not None:
        out = out - torch.softmax(-d2 / (2 * surround * width2), -1)
        out = out - out.min(-1, keepdim=True).values
        out = out / out.sum(-1, keepdim=True)
    return out


# Picture the task: a few walks, and one place cell's tuning under each target.
rng = np.random.default_rng(cfg["seed"])
walks = make_trajectories(rng, 6, 200)
fig, (ax_walk, ax_tune) = plt.subplots(1, 2, figsize=(9, 4))
c = centers.cpu().numpy()
ax_walk.scatter(c[:, 0], c[:, 1], s=4, color="0.8")
for w in walks:
    ax_walk.plot(w[:, 0], w[:, 1], lw=1)
ax_walk.set_xlim(-BOX / 2, BOX / 2)
ax_walk.set_ylim(-BOX / 2, BOX / 2)
ax_walk.set_aspect("equal")

nearest = int((centers**2).sum(-1).argmin())  # the place cell closest to the middle
xs = torch.linspace(-BOX / 2, BOX / 2, 400, device=device)
line = torch.stack([xs, torch.full_like(xs, centers[nearest, 1].item())], -1)
for surround, colour in [(cfg["surround_scale"], "tab:orange"), (None, "tab:blue")]:
    tuning = place_code(line, surround)[:, nearest].cpu().numpy()
    ax_tune.plot(xs.cpu().numpy(), tuning / tuning.max(), color=colour, lw=2)
ax_tune.axhline(0, color="0.6", lw=0.8)
ax_tune.set_ylim(-0.3, 1.1)
plt.tight_layout()
plt.show()

if env.lang == "ar":
    hardware = "بطاقة رسوميات" if device.type == "cuda" else "المعالج المركزي"
    print(f"الساحة {BOX} م × {BOX} م · {cfg['place_cells']} خلية مكان · التشغيل على {hardware}")
else:
    print(f"arena {BOX} m × {BOX} m · {cfg['place_cells']} place cells · device: {device}")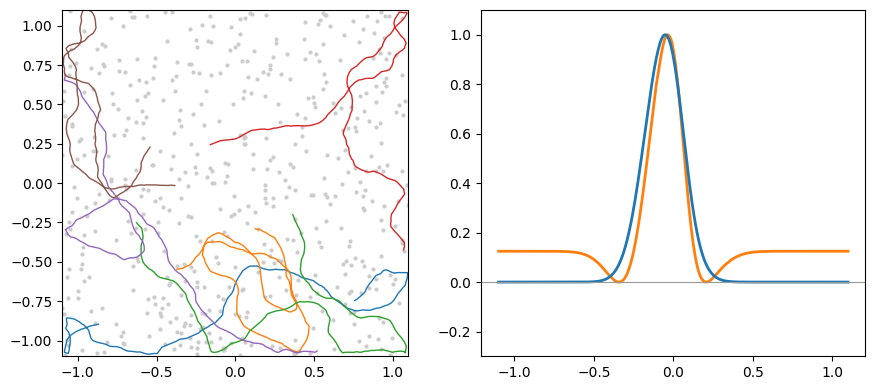
الساحة 2.2 م × 2.2 م · 512 خلية مكان · التشغيل على بطاقة رسومياتتبدأ من شيفرة خلايا المكان عند نقطة الانطلاق. بعدها لا تتلقى الشبكة في كل خطوة إلا شيئاً واحداً: كم تحركت على كل محور. ولكي تتنبأ بشيفرة المكان بعد 20 خطوة، لا مفر من أن تراكم تلك الحركات داخل حالتها المخفية. أما دالة الخسارة فتقارن نشاط خلايا المكان المتوقَّع بالنشاط الحقيقي، ولا شيء غير ذلك. ليس فيها أي حدٍّ يخص البنية المكانية أو الدورية أو الزوايا. فإن ظهرت بنيةٌ من هذا النوع لاحقاً، فلن تكون لأننا طلبناها صراحةً.
مُرمِّز لمكان الانطلاق، وطبقة تكرارية بتفعيل ReLU، وطبقة قراءة خطية في النهاية. لا شيء غير ذلك.
from torch import nn


class PathIntegrator(nn.Module):
    """Velocity in, place-cell prediction out. The hidden layer is never told what to be."""

    def __init__(self, n_place, n_hidden):
        super().__init__()
        self.encoder = nn.Linear(
            n_place, n_hidden, bias=False
        )  # starting place -> first hidden state
        self.rnn = nn.RNN(2, n_hidden, nonlinearity="relu", bias=False, batch_first=True)
        self.decoder = nn.Linear(n_hidden, n_place, bias=False)

    def hidden(self, velocity, start_code):
        states, _ = self.rnn(velocity, self.encoder(start_code)[None])
        return states

    def forward(self, velocity, start_code):
        return self.decoder(self.hidden(velocity, start_code))


def decode(logits):
    """Position estimate: the mean centre of the three most active predicted place cells."""
    return centers[logits.topk(3, dim=-1).indices].mean(-2)


def batch_tensors(pos, surround):
    pos = torch.as_tensor(pos, dtype=torch.float32, device=device)
    velocity = pos[:, 1:] - pos[:, :-1]
    return pos, velocity, place_code(pos[:, 0], surround), place_code(pos[:, 1:], surround)


params = sum(
    p.numel() for p in PathIntegrator(cfg["place_cells"], cfg["hidden_units"]).parameters()
)
if env.lang == "ar":
    print(f"{cfg['hidden_units']} وحدة مخفية · {params / 1e6:.1f} مليون معامل")
else:
print(f"{cfg['hidden_units']} hidden units · {params / 1e6:.1f}M parameters")4096 وحدة مخفية · 21.0 مليون معاملراقب خطأ الموضع الذي نستخرجه من تنبؤات خلايا المكان، لا الخسارة التي لا تكاد تتحرك. وتوقّع طويلة يبقى فيها الخطأ قرب المتر. في التشغيل المرجعي نزل الخطأ تحت نصف متر أول مرة عند الخطوة 18,000، وانتهى عند 9.400 سم. وقد خرجت البذور السبع التي جُرّبت كلها من فترة الركود، وما قيس منها خرج بين أربعة عشر ألف خطوة وعشرين ألفاً. لا توقف الخلية ما دام الخطأ ثابتاً. فخطأ الموضع هو كل ما تُكافأ عليه الشبكة، والخروج من الركود يأتي متأخراً.
import time


def train(surround):
    torch.manual_seed(cfg["seed"])  # identical initial weights for both networks
    rng = np.random.default_rng(cfg["seed"])  # identical trajectories for both networks
    model = PathIntegrator(cfg["place_cells"], cfg["hidden_units"]).to(device)
    opt = torch.optim.Adam(model.parameters(), lr=cfg["learning_rate"])
    # Half precision for the recurrent arithmetic on a GPU. A T4 in full precision
    # ran 6.4 steps/s here, almost all of it matrix multiplication. The loss stays
    # in full precision, and the scaler keeps its very small gradients from
    # rounding to zero.
    amp = device.type == "cuda"
    scaler = torch.amp.GradScaler("cuda", enabled=amp)
    if device.type == "cuda":
        torch.cuda.reset_peak_memory_stats()
    history, started = [], time.time()
    for step in range(1, cfg["train_steps"] + 1):
        pos, velocity, start, target = batch_tensors(
            make_trajectories(rng, cfg["batch"], cfg["seq_len"]), surround
        )
        with torch.autocast(device_type=device.type, dtype=torch.float16, enabled=amp):
            logits = model(velocity, start)
        logits = logits.float()
        loss = -(target * torch.log_softmax(logits, -1)).sum(-1).mean()
        loss = loss + cfg["weight_decay"] * (model.rnn.weight_hh_l0**2).sum()
        opt.zero_grad(set_to_none=True)
        scaler.scale(loss).backward()
        scaler.step(opt)
        scaler.update()
        if step % cfg["log_every"] == 0 or step == cfg["train_steps"]:
            with torch.no_grad():
                err_cm = 100 * (decode(logits) - pos[:, 1:]).norm(dim=-1).mean().item()
            history.append((step, loss.item(), err_cm))
            rate = step / (time.time() - started)
            if env.lang == "ar":
                print(
                    f"خطوة {step:>6} · الخسارة {loss.item():.3f} · خطأ الموضع {err_cm:.1f} سم · {rate:.1f} خطوة/ث"
                )
            else:
                print(
                    f"step {step:>6} · loss {loss.item():.3f} · position error {err_cm:.1f} cm · {rate:.1f} steps/s"
                )
    peak = torch.cuda.max_memory_allocated() / 2**30 if device.type == "cuda" else 0.0
    return model.eval(), np.array(history), time.time() - started, peak


dog_model, dog_history, dog_seconds, dog_peak_gb = train(cfg["surround_scale"])
train_minutes_dog = round(dog_seconds / 60, 1)
peak_vram_gb = round(dog_peak_gb, 2)
dog_final_error_cm = round(float(dog_history[-1, 2]), 1)
# The first logged step below half a metre: where the plateau broke, if it did.
broke = dog_history[dog_history[:, 2] < 50, 0]
plateau_break_step = int(broke[0]) if len(broke) else Noneخطوة 2000 · الخسارة 6.238 · خطأ الموضع 108.9 سم · 26.0 خطوة/ث
خطوة 4000 · الخسارة 6.238 · خطأ الموضع 112.1 سم · 23.9 خطوة/ث
خطوة 6000 · الخسارة 6.238 · خطأ الموضع 111.7 سم · 23.1 خطوة/ث
خطوة 8000 · الخسارة 6.238 · خطأ الموضع 105.0 سم · 22.7 خطوة/ث
خطوة 10000 · الخسارة 6.238 · خطأ الموضع 104.1 سم · 22.5 خطوة/ث
خطوة 12000 · الخسارة 6.235 · خطأ الموضع 94.0 سم · 22.4 خطوة/ث
خطوة 14000 · الخسارة 6.232 · خطأ الموضع 89.6 سم · 22.4 خطوة/ث
خطوة 16000 · الخسارة 6.222 · خطأ الموضع 69.5 سم · 22.5 خطوة/ث
خطوة 18000 · الخسارة 6.210 · خطأ الموضع 39.4 سم · 22.5 خطوة/ث
خطوة 20000 · الخسارة 6.197 · خطأ الموضع 19.2 سم · 22.5 خطوة/ث
خطوة 22000 · الخسارة 6.190 · خطأ الموضع 15.6 سم · 22.5 خطوة/ث
خطوة 24000 · الخسارة 6.186 · خطأ الموضع 13.2 سم · 22.5 خطوة/ث
خطوة 26000 · الخسارة 6.182 · خطأ الموضع 11.3 سم · 22.5 خطوة/ث
خطوة 28000 · الخسارة 6.182 · خطأ الموضع 11.2 سم · 22.5 خطوة/ث
خطوة 30000 · الخسارة 6.181 · خطأ الموضع 9.4 سم · 22.5 خطوة/ثالمسارات نفسها بالترتيب نفسه، ومن الأوزان الابتدائية نفسها. في الرسم، المحور الأفقي خطوات التدريب، والعمودي خطأ الموضع بالسنتيمترات. ينخفض المنحنى الأزرق خلال بضعة آلاف من الخطوات، أما البرتقالي فيصل متأخراً كثيراً ويستقر أعلى منه. فإن لم ينخفض المنحنى الأزرق أبداً، فالتوأم لم يتعلم المهمة، وكل ما سنقوله عنه لاحقاً بلا معنى.
control_model, control_history, control_seconds, _ = train(None)
train_minutes_control = round(control_seconds / 60, 1)

fig, ax = plt.subplots(figsize=(6, 3.5))
ax.plot(dog_history[:, 0], dog_history[:, 2], color="tab:orange", lw=2)
ax.plot(control_history[:, 0], control_history[:, 2], color="tab:blue", lw=2)
ax.set_ylim(bottom=0)  # zero-based: both curves must visibly reach the floor
plt.tight_layout()
plt.show()خطوة 2000 · الخسارة 3.572 · خطأ الموضع 12.2 سم · 23.0 خطوة/ث
خطوة 4000 · الخسارة 3.451 · خطأ الموضع 10.0 سم · 23.1 خطوة/ث
خطوة 6000 · الخسارة 3.200 · خطأ الموضع 5.2 سم · 23.2 خطوة/ث
خطوة 8000 · الخسارة 3.134 · خطأ الموضع 5.1 سم · 23.2 خطوة/ث
خطوة 10000 · الخسارة 3.092 · خطأ الموضع 4.4 سم · 23.2 خطوة/ث
خطوة 12000 · الخسارة 3.106 · خطأ الموضع 4.4 سم · 23.2 خطوة/ث
خطوة 14000 · الخسارة 3.100 · خطأ الموضع 4.4 سم · 23.2 خطوة/ث
خطوة 16000 · الخسارة 3.119 · خطأ الموضع 4.4 سم · 23.2 خطوة/ث
خطوة 18000 · الخسارة 3.071 · خطأ الموضع 4.6 سم · 23.2 خطوة/ث
خطوة 20000 · الخسارة 3.105 · خطأ الموضع 4.3 سم · 23.2 خطوة/ث
خطوة 22000 · الخسارة 3.082 · خطأ الموضع 4.2 سم · 23.2 خطوة/ث
خطوة 24000 · الخسارة 3.084 · خطأ الموضع 4.2 سم · 23.3 خطوة/ث
خطوة 26000 · الخسارة 3.113 · خطأ الموضع 4.4 سم · 23.3 خطوة/ث
خطوة 28000 · الخسارة 3.070 · خطأ الموضع 4.3 سم · 23.3 خطوة/ث
خطوة 30000 · الخسارة 3.097 · خطأ الموضع 4.5 سم · 23.3 خطوة/ث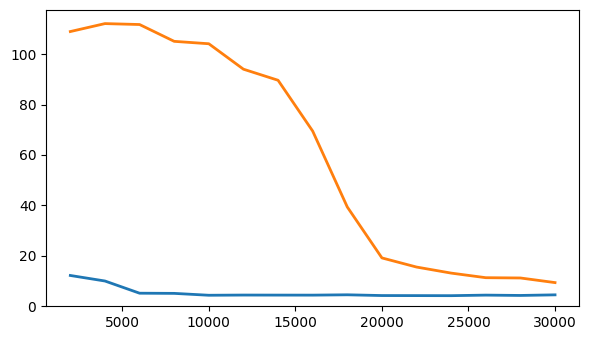
لكي ترى هل تحمل وحدةٌ مخفية ، مرّر الشبكة المدرَّبة عبر آلاف المسارات الجديدة، واحسب متوسط نشاط تلك الوحدة في كل مربع من أرضٍ مقسمة إلى 20×20 مربعاً. الناتج هو خريطة نشاطها. ولكي نقيّم الخريطة، نحسب : نقارنها بنسخٍ مُزاحة منها. النمط المتكرر ينطبق على نفسه كلما أزحناه دورةً كاملة، وكل إزاحة من هذه تظهر قمةً في الصورة الناتجة. لذلك يتحول أي نمط متكرر إلى حلقة من القمم حول المركز. ثم نُدير هذه الصورة. النمط السداسي ينطبق على نفسه عند 60° و120°، ولا ينطبق عند 30° و90° و150°. والفرق بين الحالتين هو ما نسمّيه «درجة السداسية». أما النمط المربّع والنمط المخطط فينالان درجة قريبة من الصفر أو دونه.
تقارن المهارةُ كل شبكة بتخمينٍ لا يغادر نقطة البداية: الواحد أداء مثالي، والصفر يعني أنها لم تتعلم شيئاً. يجب أن يكون الرقمان أعلى من الصفر بوضوح قبل أن تستحق أي خريطة في الأسفل القراءة. لكنهما لن يتساويا: فالتوأم الغاوسي أدق في الملاحة، إذ بلغت مهارته في التشغيل المرجعي 0.771 مقابل 0.484، وهذا الفارق مهم لكل ما يلي.
@torch.no_grad()
def survey(model, surround, seq_len, skip=0):
    """Walk the trained network through fresh trajectories.

    Returns (rate maps [units, res, res], stability [units], decoding skill,
    error in cm, error in cm of always guessing the box centre).
    Only steps at index >= skip are binned and scored. Skill = 1 - model error /
    error of a guess that never moves from the starting point, so 0 means "did
    not integrate". That guess gets worse as walks get longer, so skill is only
    comparable between walks of the same length; the centimetre errors are not.
    Stability correlates the maps built from two halves of the walks: a real map
    agrees with itself, noise does not.
    """
    res = cfg["map_res"]
    rng = np.random.default_rng(cfg["seed"] + 1)  # unseen trajectories, same for both networks
    sums = torch.zeros(2, res * res, cfg["hidden_units"], device=device)
    counts = torch.zeros(2, res * res, device=device)
    model_err, still_err, centre_err = 0.0, 0.0, 0.0
    for batch in range(cfg["eval_batches"]):
        pos, velocity, start, _ = batch_tensors(
            make_trajectories(rng, cfg["batch"], seq_len), surround
        )
        states = model.hidden(velocity, start)[:, skip:]
        where = pos[:, 1 + skip :]
        model_err += (decode(model.decoder(states)) - where).norm(dim=-1).mean().item()
        still_err += (pos[:, :1] - where).norm(dim=-1).mean().item()
        centre_err += where.norm(dim=-1).mean().item()
        cell = ((where + BOX / 2) / BOX * res).long().clamp(0, res - 1)
        index = (cell[..., 0] * res + cell[..., 1]).reshape(-1)
        half = batch % 2
        sums[half].index_add_(0, index, states.reshape(-1, states.shape[-1]))
        counts[half].index_add_(0, index, torch.ones_like(index, dtype=torch.float32))
    maps = (sums.sum(0) / counts.sum(0).clamp(min=1)[:, None]).T.reshape(-1, res, res).cpu().numpy()
    halves = sums / counts.clamp(min=1)[..., None]  # (2, bins, units)
    seen = (counts > 0).all(0)
    a, b = halves[0][seen], halves[1][seen]
    a, b = a - a.mean(0), b - b.mean(0)
    stability = (
        ((a * b).sum(0) / ((a * a).sum(0) * (b * b).sum(0)).sqrt().clamp(min=1e-12)).cpu().numpy()
    )
    per_batch_cm = 100 / cfg["eval_batches"]
    return (
        maps,
        stability,
        1 - model_err / still_err,
        model_err * per_batch_cm,
        centre_err * per_batch_cm,
    )


dog_maps, dog_stability, dog_skill, dog_err_cm, _ = survey(
    dog_model, cfg["surround_scale"], cfg["seq_len"]
)
control_maps, control_stability, control_skill, control_err_cm, _ = survey(
    control_model, None, cfg["seq_len"]
)
dog_skill, control_skill = round(dog_skill, 3), round(control_skill, 3)

if env.lang == "ar":
    print(
        f"مهارة تكامل المسار · هدف المركز والمحيط {dog_skill:.3f} · الهدف الغاوسي {control_skill:.3f}"
    )
    print(
        f"خطأ الموضع · هدف المركز والمحيط {dog_err_cm:.1f} سم · الهدف الغاوسي {control_err_cm:.1f} سم"
    )
else:
    print(
        f"path-integration skill · centre-surround {dog_skill:.3f} · Gaussian {control_skill:.3f}"
    )
    print(
        f"position error · centre-surround {dog_err_cm:.1f} cm · Gaussian {control_err_cm:.1f} cm"
)مهارة تكامل المسار · هدف المركز والمحيط 0.484 · الهدف الغاوسي 0.771
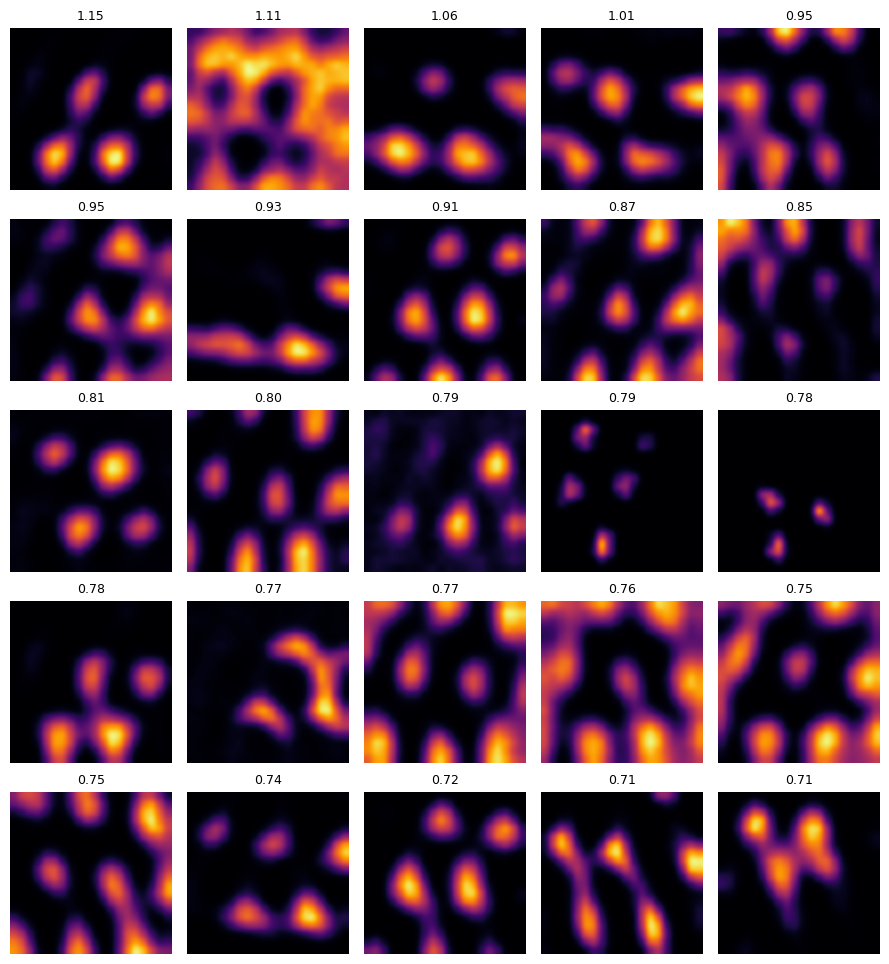
خطأ الموضع · هدف المركز والمحيط 10.0 سم · الهدف الغاوسي 4.4 سمأعلى 25 وحدة مخفية درجةً في شبكة المركز والمحيط، كل واحدة مرسومة على أرض الصندوق وفوقها درجتها. ابحث عن بقع مرتبة في مثلثات، لكل وحدة تباعدها واتجاهها وإزاحتها الخاصة. وبدقة 20×20 تبقى الخرائط خشنة، ولا يتسع الصندوق إلا لدورات قليلة من نمط بهذا الاتساع، فتُظهر بعض الوحدات ثلاث بقع أو أربعاً فقط. والسطر المطبوع تحت الصورة لا يقل أهمية عنها. فالشبكة نفسها قبل التدريب ترسم خرائط منقّطة عشوائية، وهذا التنقيط قد ينال درجة تتجاوز الواحد بمحض الصدفة. لذلك يجب على الوحدة السداسية أيضاً أن ترسم الخريطة نفسها من نصفين منفصلين من المسارات، وهذا ما يفعله النمط السداسي ولا يفعله التنقيط أبداً. وهذه البذرة من أقوى البذور؛ ويبيّن القسم الختامي ما جرى في البذور الأخرى.
def autocorrelogram(maps):
    """Normalised spatial autocorrelation of each map, shape (units, 2*res-1, 2*res-1)."""
    n, res, _ = maps.shape
    size = 2 * res - 1
    x = np.zeros((n, size, size))
    x[:, :res, :res] = maps - maps.mean(axis=(1, 2), keepdims=True)
    ones = np.zeros((1, size, size))
    ones[:, :res, :res] = 1.0

    def xcorr(a, b):
        return np.fft.fftshift(
            np.real(np.fft.ifft2(np.fft.fft2(a) * np.conj(np.fft.fft2(b)))), axes=(1, 2)
        )

    overlap = np.round(xcorr(ones, ones))
    s_a, s_b = xcorr(x, ones), xcorr(ones, x)
    s_ab, s_aa, s_bb = xcorr(x, x), xcorr(x**2, ones), xcorr(ones, x**2)
    num = overlap * s_ab - s_a * s_b
    den = np.sqrt(
        np.clip(overlap * s_aa - s_a**2, 0, None) * np.clip(overlap * s_bb - s_b**2, 0, None)
    )
    sac = np.where((den > 1e-12) & (overlap >= 20), num / np.maximum(den, 1e-12), 0.0)
    return sac  # zero lag sits at index res-1 on both axes


def rotate(images, degrees):
    """Bilinear rotation about the centre, keeping the frame."""
    _, h, w = images.shape
    theta = math.radians(degrees)
    yy, xx = np.mgrid[0:h, 0:w].astype(float)
    cy, cx = (h - 1) / 2, (w - 1) / 2
    src_x = math.cos(theta) * (xx - cx) + math.sin(theta) * (yy - cy) + cx
    src_y = -math.sin(theta) * (xx - cx) + math.cos(theta) * (yy - cy) + cy
    x0, y0 = np.floor(src_x).astype(int), np.floor(src_y).astype(int)
    fx, fy = src_x - x0, src_y - y0
    out = np.zeros_like(images)
    for dy, dx, weight in [
        (0, 0, (1 - fx) * (1 - fy)),
        (0, 1, fx * (1 - fy)),
        (1, 0, (1 - fx) * fy),
        (1, 1, fx * fy),
    ]:
        yi, xi = y0 + dy, x0 + dx
        inside = (yi >= 0) & (yi < h) & (xi >= 0) & (xi < w)
        out += images[:, yi.clip(0, h - 1), xi.clip(0, w - 1)] * (weight * inside)
    return out


def grid_scores(maps):
    """Sixfold symmetry of each map: min(r60, r120) - max(r30, r90, r150), best over ring sizes."""
    sac = autocorrelogram(maps)
    n, size, _ = sac.shape
    res = maps.shape[1]
    r = np.hypot(*(np.mgrid[0:size, 0:size] - (size - 1) / 2))
    rotated = {a: rotate(sac, a).reshape(n, -1) for a in (30, 60, 90, 120, 150)}
    flat = sac.reshape(n, -1)
    best = np.full(n, -np.inf)
    # Rings stop at ring_max of the map width. Beyond it two copies of the map
    # barely overlap, the autocorrelogram is noise, and in the first T4 run that
    # noise gave single blobs scores above 1.1. The cap keeps full sensitivity to
    # lattices up to 0.7 of the box apart.
    for outer in np.linspace(0.4, cfg["ring_max"], 10):
        ring = ((r >= 0.2 * res) & (r <= outer * res)).reshape(-1)
        a = flat[:, ring] - flat[:, ring].mean(1, keepdims=True)
        corr = {}
        for angle, rot in rotated.items():
            b = rot[:, ring] - rot[:, ring].mean(1, keepdims=True)
            corr[angle] = (a * b).sum(1) / np.sqrt((a**2).sum(1) * (b**2).sum(1) + 1e-12)
        score = np.minimum(corr[60], corr[120]) - np.maximum(
            np.maximum(corr[30], corr[90]), corr[150]
        )
        best = np.maximum(best, score)
    return best, sac


def show_maps(maps, scores, count, cmap):
    order = np.argsort(-scores)[:count]  # callers pass unstable units as -inf
    cols = math.ceil(math.sqrt(count))
    rows = math.ceil(count / cols)
    _, axes = plt.subplots(rows, cols, figsize=(1.8 * cols, 1.95 * rows))
    for ax, unit in zip(axes.ravel()[: len(order)], order, strict=True):
        ax.imshow(maps[unit].T, origin="lower", cmap=cmap, interpolation="gaussian")
        ax.set_title(f"{scores[unit]:.2f}", fontsize=9)
    for ax in axes.ravel():
        ax.axis("off")
    plt.tight_layout()
    plt.show()
    return order


def grid_units(maps, scores, stability):
    """A grid unit scores above the cut AND draws the same map from both halves of the walks.

    Returns (mask over units, percent of active units)."""
    active = maps.std(axis=(1, 2)) > 1e-6  # silent units have no map to score
    mask = active & (scores > cfg["grid_score_cut"]) & (stability > cfg["stability_min"])
    return mask, round(100 * float(mask[active].mean()), 1)


# The null. In the same network before training, maps are speckle, and speckle
# can score above 1 by pure chance: on T4 runs about 15% of untrained units
# cleared a score of 0.3, as many as in the trained network. Speckle cannot
# repeat itself across two halves of the data, so the stability test removes it.
torch.manual_seed(cfg["seed"])
untrained = PathIntegrator(cfg["place_cells"], cfg["hidden_units"]).to(device).eval()
untrained_maps, untrained_stability, *_ = survey(untrained, cfg["surround_scale"], cfg["seq_len"])
_, grid_percent_untrained = grid_units(
    untrained_maps, grid_scores(untrained_maps)[0], untrained_stability
)

dog_scores, dog_sac = grid_scores(dog_maps)
control_scores, _ = grid_scores(control_maps)
dog_grid, grid_percent_dog = grid_units(dog_maps, dog_scores, dog_stability)
control_grid, grid_percent_control = grid_units(control_maps, control_scores, control_stability)
active_dog = dog_maps.std(axis=(1, 2)) > 1e-6
active_control = control_maps.std(axis=(1, 2)) > 1e-6
grid_advantage_points = round(grid_percent_dog - grid_percent_control, 1)


# The whole distributions, not just their tails. Across seeds the share of grid
# units varied twentyfold, but the centre-surround median sat above the Gaussian
# twin's in every seed where both were measured, including the weakest.
# Medians are over STABLE units. Over all active units, untrained weights alone
# give a gap of about 0.14, because the start code shifts the speckle's scores;
# speckle is never stable, so an untrained network has no median to offer and
# the check cannot pass on noise.
def stable_median(scores, stability, active):
    keep = active & (stability > cfg["stability_min"])
    return (
        round(float(np.median(scores[keep])), 3)
        if keep.sum() >= cfg["units_shown"]
        else float("nan")
    )


dog_median_score = stable_median(dog_scores, dog_stability, active_dog)
control_median_score = stable_median(control_scores, control_stability, active_control)
median_gap = round(dog_median_score - control_median_score, 3)
cut = cfg["grid_score_cut"]
best_grid_score = round(float(dog_scores.max()), 2)

stable_dog = np.where(dog_stability > cfg["stability_min"], dog_scores, -np.inf)
top_dog_units = show_maps(dog_maps, stable_dog, cfg["units_shown"], "inferno")

if env.lang == "ar":
    print(
        f"وحدات سداسية مستقرة · {grid_percent_dog}% بعد التدريب · {grid_percent_untrained}% بالأوزان نفسها قبله"
    )
else:
    print(
        f"stable grid units · trained {grid_percent_dog}% · same weights before training {grid_percent_untrained}%"
    )
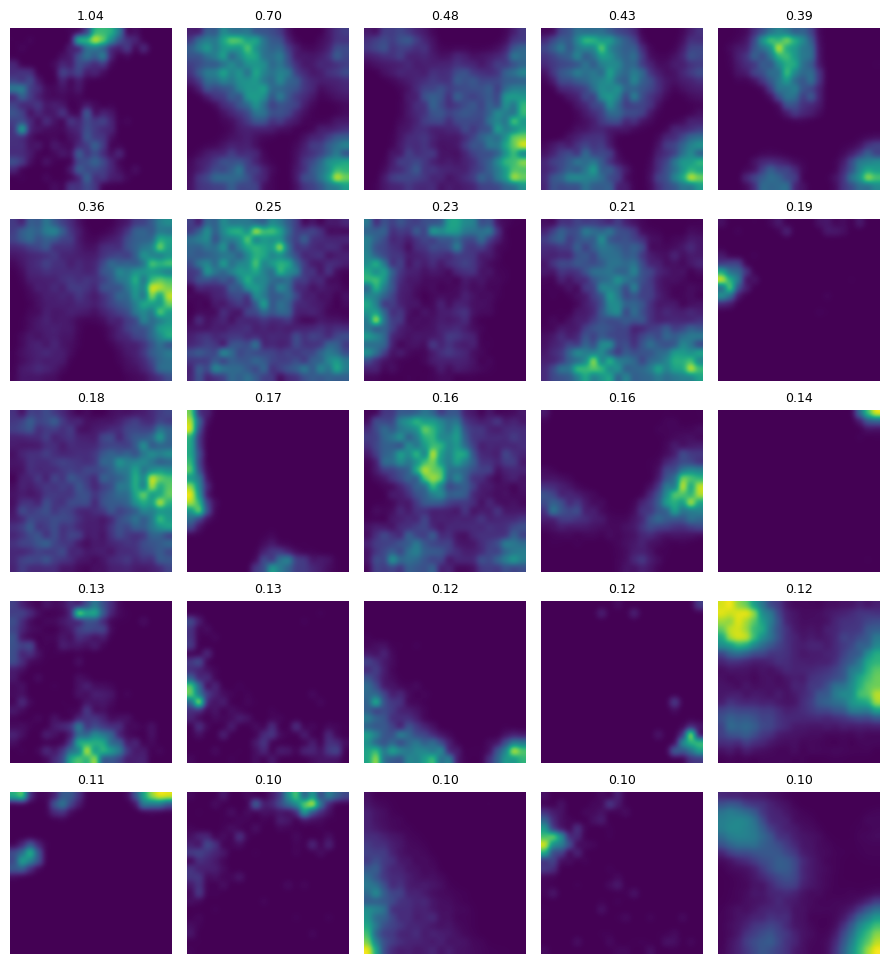
وحدات سداسية مستقرة · 16.6% بعد التدريب · 2.0% بالأوزان نفسها قبلهأولاً أفضل وحدات التوأم المستقرة، مرتبة بالطريقة نفسها. وقد ينال بعضها درجة عالية وهو لا يُظهر إلا بقعة واحدة. فالدرجة ليست كاشفاً مثالياً، ولهذا نبني الحكم على النسب المئوية، لا على خريطة بعينها. ثم توزيع الدرجات على كل الوحدات النشطة: البرتقالي للمركز والمحيط، والأزرق للغاوسي، والخط المتقطع عند العتبة، وخط متصل عند وسيط كل توزيع. وبجانبه خريطة الارتباط الذاتي لوحدة سداسية مستقرة. في النمط النظيف تشكّل أقرب القمم إلى المركز شكلاً سداسياً. وبهذه الدقة، توقّع أن يظهر هذا الشكل وسط التشويش، لا واضحاً حادّ الحواف.
stable_control = np.where(control_stability > cfg["stability_min"], control_scores, -np.inf)
top_control_units = show_maps(control_maps, stable_control, cfg["units_shown"], "viridis")

fig, (ax_hist, ax_sac) = plt.subplots(1, 2, figsize=(9, 3.8))
bins = np.linspace(-1.0, 1.8, 57)
ax_hist.hist(control_scores[active_control], bins=bins, color="tab:blue", alpha=0.55, density=True)
ax_hist.hist(dog_scores[active_dog], bins=bins, color="tab:orange", alpha=0.55, density=True)
ax_hist.axvline(cut, color="0.2", ls="--", lw=1)
ax_hist.axvline(control_median_score, color="tab:blue", lw=2)
ax_hist.axvline(dog_median_score, color="tab:orange", lw=2)
# The exemplar is the steadiest grid unit that fires over a real part of the
# floor. The top scorer can be a unit with a few tiny spots, which scores well
# and draws a noisy autocorrelogram; a stable, well-covered map draws a cleaner one.
coverage = (dog_maps > 0.5 * dog_maps.max(axis=(1, 2), keepdims=True)).mean(axis=(1, 2))
candidates = np.flatnonzero(dog_grid & (coverage >= 0.15))
exemplar = (
    int(candidates[np.argmax(dog_stability[candidates])])
    if len(candidates)
    else int(top_dog_units[0])
)
ax_sac.imshow(dog_sac[exemplar].T, origin="lower", cmap="RdBu_r", vmin=-1, vmax=1)
ax_sac.axis("off")
plt.tight_layout()
plt.show()

if env.lang == "ar":
    print(
        f"وحدات سداسية مستقرة · هدف المركز والمحيط {grid_percent_dog}% · الهدف الغاوسي {grid_percent_control}%"
    )
    print(
        f"وسيط الدرجات · هدف المركز والمحيط {dog_median_score:+.2f} · الهدف الغاوسي {control_median_score:+.2f} · الفارق {median_gap:+.2f}"
    )
else:
    print(
        f"stable grid units · centre-surround {grid_percent_dog}% · Gaussian {grid_percent_control}%"
    )
    print(
        f"median score · centre-surround {dog_median_score:+.2f} · Gaussian {control_median_score:+.2f} · gap {median_gap:+.2f}"
    )
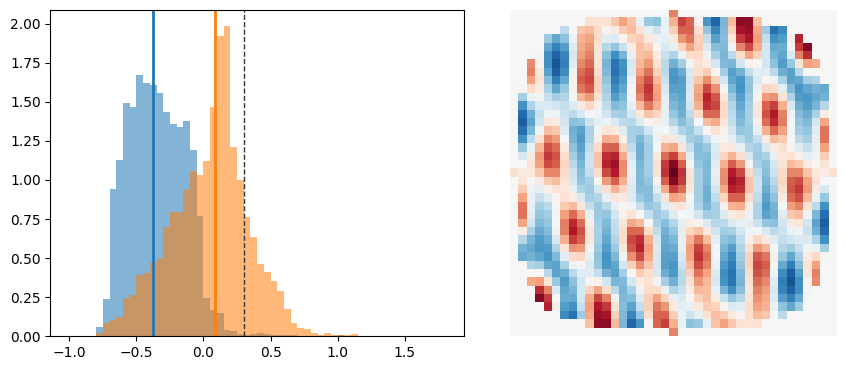
وحدات سداسية مستقرة · هدف المركز والمحيط 16.6% · الهدف الغاوسي 0.2%
وسيط الدرجات · هدف المركز والمحيط +0.09 · الهدف الغاوسي -0.38 · الفارق +0.46
في هذا التشغيل كانت 16.600% من الوحدات النشطة في شبكة المركز والمحيط وحداتٍ سداسية مستقرة، مقابل 0.200% في توأمها، و2% في الشبكة نفسها بأوزانها قبل التدريب. وبلغ وسيط درجاتها 0.086، ووسيط درجات التوأم -0.377. غير أن التوأم كان الأدق في الملاحة. ولو كانت السداسيات شرطاً لتكامل المسار، لكانت الشبكة الأدق هي الأغنى بها. فالسداسيات إذن ليست ما يحتاجه تكامل المسار هنا.
لكن هذه النتيجة تخص بذرة واحدة، وقد اخترناها عن قصد. فالبذرة تحدد مواضع خلايا المكان والمسارات والأوزان الابتدائية معاً. وقبل أن نعرف أي نتيجة، ثبّتنا سبع بذور ودرّبنا شبكة المركز والمحيط على كل منها. تعلّمت السبع كلها الملاحة. وكانت حصص الوحدات السداسية المستقرة فيها 1.0 و3.5 و4.1 و11.7 و12.8 و16.6 و22.4%، وتجاوزت أربعٌ منها عتبة 8%. تستخدم هذه الورشة البذرة ذات الـ16.6%، وهي الثانية قوةً، وقد أعدنا تشغيلها في جلسات منفصلة فجاءت النتيجة متطابقة.
وثبت أمران عبر البذور. الأول: كان التوأم الأدق في الملاحة في البذور الأربع التي دُرّبت فيها الشبكتان كلتاهما. والثاني: بقيت درجات شبكة المركز والمحيط في مجملها أعلى من درجات التوأم، حتى حين لم يكد النمط يتشكل. ففي أضعف بذرتين، وحصتاهما قريبتان من مستوى الشبكة غير المدرَّبة، بقي فارق الوسيط 0.15 و0.19. الميل نحو البنية السداسية كان ثابتاً، أما النمط الذي ينتج عنه فلم يكن كذلك.
اقترح سورشر وميل وغانغولي وأوكو عام 2019 آليةً تفسّر ذلك. الطوق الكابح يعاقب الأنماط المكانية الواسعة جداً والدقيقة جداً في آنٍ واحد. فيميل هذا الهدف إلى وحداتٍ مبنية حول تردد مكاني واحد مفضّل، أي وحداتٍ تتكرر قممها بتباعدٍ واحد تقريباً. وهناك قيد آخر: معدلات النشاط لا يمكن أن تكون سالبة. ومن بين الأنماط المبنية على تردد واحد، يفوز النمط المثلثي تحت هذا القيد. هذا يصف ما تفضّله ، لا ما إذا كان تشغيلٌ بعينه سيبلغه. فالتشغيل المحدود بهذا الحجم يقترب منه بمقدارٍ يتوقف على البذرة.
ثم رأى شيفر وخونا وفيتي عام 2022 أن في هذه النماذج مرهونةٌ باختيارات يتخذها من يبني النموذج، وأنها أهشّ مما بدا أول الأمر. ورأوا كذلك أن الشبكة حين تعيد إنتاج نمطٍ نراه في الدماغ، فهذا دليلٌ على طبيعة دالة الهدف، لا برهانٌ على أن الدماغ يحسّن الدالة نفسها. والبذور السبع هنا مثال صغير على الفكرة نفسها.
وقبل أن تبني الكثير على فارق الملاحة، تنبّه إلى أمر. الموضع يُستخرج من أنشط ثلاث خلايا مكان في التنبؤ. ونحو ثلاثة أرباع شيفرة المركز والمحيط أرضيةٌ شبه مسطحة، فقمّتها أصعب قراءةً. قد يعود جزء من الفارق إذن إلى صعوبة القراءة، لا إلى ضعف التكامل. وهذا التشغيل لا يستطيع الفصل بين الاثنين.
لم يطلب أحدٌ السداسيات. شكلُ الهدف هو الذي طلبها، وإن بطريقٍ غير مباشر. وهو يطلبها في كل تشغيل، لكن النمط لا يستجيب إلا في بعض التشغيلات.
تمرين
لم ترَ الشبكة قط مساراً أطول من 20 خطوة، وهنا تختبر على مسارات أطول. ارفع قيمة LENGTH_MULTIPLE، ولا تقيّم إلا الخطوات الواقعة بعد ذلك الأفق. الصف العلوي يعيد رسم أفضل الوحدات كما كانت، والصف السفلي يرسم الوحدات نفسها على المسارات الطويلة. ويقارن السطر المطبوع خطأ الموضع بالسنتيمترات داخل الأفق وبعده، إلى جانب خطأ من يخمّن مركز الصندوق دائماً. قرّر أيهما ينكسر أولاً: طبقة قراءة الموضع أم النمط السداسي؟ وماذا يخبرك ذلك عن المكان الذي تحتفظ فيه الشبكة بإحساسها بالموقع؟
# YOUR TURN.
# The network only ever saw walks of cfg["seq_len"] steps. Run it for longer and
# score only the steps it was never trained on. Try 1, then 3, 5, 10.
# Errors are compared in centimetres: skill is measured against standing still,
# and standing still gets worse on longer walks, which would flatter the network.
LENGTH_MULTIPLE = 5

long_len = cfg["seq_len"] * LENGTH_MULTIPLE
long_maps, _, _, long_err_cm, centre_cm = survey(
    dog_model, cfg["surround_scale"], long_len, skip=cfg["seq_len"] if LENGTH_MULTIPLE > 1 else 0
)
long_scores, _ = grid_scores(long_maps)
kept = [float(long_scores[u]) for u in top_dog_units]

fig, axes = plt.subplots(2, 8, figsize=(14, 3.8))
for i, unit in enumerate(top_dog_units[:8]):
    axes[0, i].imshow(dog_maps[unit].T, origin="lower", cmap="inferno", interpolation="gaussian")
    axes[1, i].imshow(long_maps[unit].T, origin="lower", cmap="inferno", interpolation="gaussian")
    axes[0, i].set_title(f"{dog_scores[unit]:.2f}", fontsize=9)
    axes[1, i].set_title(f"{long_scores[unit]:.2f}", fontsize=9)
for ax in axes.ravel():
    ax.axis("off")
plt.tight_layout()
plt.show()

if env.lang == "ar":
    print(
        f"مسارات أطول بـ {LENGTH_MULTIPLE} مرات · خطأ الموضع بعد أفق التدريب {long_err_cm:.1f} سم"
    )
    print(f"داخل الأفق {dog_err_cm:.1f} سم · تخمين مركز الصندوق دائماً {centre_cm:.1f} سم")
    print(
        f"متوسط درجة الوحدات نفسها {np.mean(kept):.2f} (كان {np.mean(dog_scores[top_dog_units]):.2f})"
    )
else:
    print(
        f"walks {LENGTH_MULTIPLE}× longer · position error beyond the training horizon {long_err_cm:.1f} cm"
    )
    print(
        f"within the horizon {dog_err_cm:.1f} cm · always guessing the box centre {centre_cm:.1f} cm"
    )
    print(
        f"mean score of the same units {np.mean(kept):.2f} (was {np.mean(dog_scores[top_dog_units]):.2f})"
)يتوفّر تلميح في الدفتر — env.hint(1)
الملاحة أولاً؛ فمقارنة الأنماط السداسية لا معنى لها إلا إذا نجحت الشبكتان في هذا الاختبار.
# Control first: a grid comparison between networks that cannot find their way
# would be a comparison between two kinds of noise. Then the finding that held in
# every seed measured: the centre-surround scores shifted above the twin's.
# The share of lattice units is reported, not required: across seven seeds it
# ranged from 1% to 22%, and a required check on it would fail seeds, not learners.
integrates_ok = env.check("both-integrate", min(dog_skill, control_skill))
pull_ok = env.check("surround-pull", median_gap)
grids_ok = env.check("grid-units", grid_percent_dog)✓ مهارة تكامل المسار لدى الأضعف بين الشبكتين: 0.484 (المطلوب ≥ 0.35)
✓ وسيط درجات شبكة المركز والمحيط مطروحاً منه وسيط درجات توأمها الغاوسي: 0.463 (المطلوب ≥ 0.08)
✓ نسبة وحدات شبكة المركز والمحيط التي تُعدّ وحدات سداسية: تتجاوز عتبة الدرجة وتبقى خريطتها ثابتة بين نصفي البيانات: 16.6 (المطلوب ≥ 8)رمز الإكمال، وما يوثّق مصدر هذا التشغيل.
receipt = env.receipt()اكتملت الورشة.
رمز الإتمام: AZ-██████████
الصقه في صفحة الورشة على أزيموث لتسجيل إتمامها.مصطلحات هذه الورشة
- الشبكة العصبية التكراريةRecurrent Neural Network (RNN)
- الحالة المخفيةHidden State
- تكامل المسارPath Integration
- التمثيل المكانيSpatial Representation
- السلوك الناشئEmergent Behavior
- التمثيل الناشئEmergent Representation
- تعلم التمثيلات الرقميةRepresentation Learning
- الفضاء الكامنLatent Space
- العصبون الاصطناعيNeuron
- خريطة السماتFeature Map
- التعميمGeneralization
- البيئة التفاعليةEnvironment
- فضاء المشاهداتObservation Space
- مسار تتابع الحالات والأفعالTrajectory
- التحديث التراجعي عبر الزمنBackpropagation Through Time