تعلم الآلة الكلاسيكيintermediateمعالج رسوميات اختياري~30 دقيقةColab
الهبوط المزدوج: ما بعد عتبة الاستيفاء
Double Descent: Past the Interpolation Threshold
يبلغ خطأ الاختبار ذروته حين يتساوى عدد المعاملات مع عدد نقاط البيانات، لا حين يصبح النموذج معقّداً أكثر من اللازم
تعلّمتَ أن خطأ الاختبار يرسم منحنى على شكل حرف U. النموذج البسيط جداً يقصر عن ملاءمة البيانات، والنموذج المعقّد جداً يفرط في ملاءمتها، والنقطة المثلى تقع بينهما. وبحسب هذه القاعدة، تتوقّف عن تكبير النموذج حين يبدأ خطأ الاختبار بالصعود. في هذه الورشة لا نتوقّف. نكبّر نموذجاً واحداً من بضعة معاملات إلى عشرين ضعف عدد نقاط التدريب. ثم نقارن ما يتنبّأ به منحنى U بما يحدث فعلاً.
الهدف
أن تحدّد موضع ذروة خطأ الاختبار، وتُثبت أنها تقع عند عتبة الاستيفاء، أي حيث يساوي عدد المعاملات عدد نقاط التدريب. ثم أن تتحقّق من أن أعرض نموذج يلائم بيانات تدريبه ملاءمة تامّة، ومع ذلك يهبط خطؤه بعيداً عن الذروة. وأخيراً أن تقيس سبب ذلك، وما الذي يُزيل الذروة.
يفتح Colab نسخة للقراءة فقط. احفظ نسخة في Drive للاحتفاظ بتعديلاتك.
يحتاج الدفتر إلى لوحة مفاتيح — يُفضَّل فتحه على حاسوب مكتبي.
الأوراق وراء هذه الورشة
رسم مقرّر الإحصاء صورة واحدة. في طرفها الأيسر نموذج أبسط من أن يلتقط النمط، فيكون انحيازه عالياً، ويقصر عن ملاءمة البيانات. وفي طرفها الأيمن نموذج مرن إلى حدّ أنه يلاحق الضجيج في عيّنة التدريب، فيكون تباينه عالياً، ويفرط في الملاءمة. خطأ الاختبار هو مجموع الاثنين، ولذلك يرسم منحنى على شكل U. والمطلوب أن نتوقّف عند قاع هذا المنحنى.
هذه الصورة ليست خاطئة في ما تصفه. لكنها رُسمت لنماذج تتوقّف قبل أن تلائم كل نقطة تدريب. أما النماذج الحديثة فتتجاوز هذه النقطة بكثير، وهذا أمر معتاد فيها. وسؤال هذه الورشة بسيط: ماذا يحدث لخطأ الاختبار إذا واصلنا إضافة المعاملات بعد أن يصل خطأ التدريب إلى الصفر؟
لا شيء نبحث عنه بعد. تربط هذه الخلية الدفتر بملفّ التشغيل، وتعرّف الدوال المساعدة التي تطبع النصوص وتكتب عناوين الرسوم بلغتك.
import azimuth_nb as azimuth

env = azimuth.setup(SLUG, lang=LANG, profile=PROFILE)


def say(en, ar_text):
    # One program, two voices: the Arabic build prints the Arabic line.
    print(ar_text if env.lang == "ar" else en)


def t(en, ar_text):
    # Figure text. matplotlib draws glyphs one by one, left to right, so raw
    # Arabic comes out as isolated letters in reversed order. Two steps fix it:
    # reshape joins the letters into their connected forms, and get_display
    # puts the line in visual order (Latin runs such as "p = n" stay readable).
    # Reshaping also drops the vowel marks, which matplotlib cannot position.
    if env.lang != "ar":
        return en
    import arabic_reshaper
    from bidi.algorithm import get_display

return get_display(arabic_reshaper.reshape(ar_text))الهبوط المزدوج: ما بعد عتبة الاستيفاء
بدون معالج رسوميات · ذاكرة 12.7 غ.ب · PyTorch 2.11.0+cpu
الملف: free
جاهز · seed=17, n_train=200, n_test=2000, dim=20, noise=0.5, p_max=4000, grid_points=40, trials=5, ridge=0.01, gd_width=1000, gd_steps=20000
الشيفرة · afc86a2a2abdb407لكي نكبّر النموذج تكبيراً نظيفاً، نحتاج إلى شرطين. الأول أن يكون حجم النموذج رقماً واحداً. والثاني ألّا تتأثّر الملاءمة بتفاصيل جدول التدريب، كمعدّل التعلّم وعدد الحقب. نموذج السمات العشوائية يحقّق الشرطين معاً. يمرّ المُدخل عبر طبقة ثابتة من p وحدة ReLU، أوزانها مسحوبة عشوائياً. ثم نلائم أوزان المخرج وحدها، وعددها p، بطريقة المربعات الصغرى. إذن p هو عدد المعاملات. ولأن الطبقة الأولى لا تتغيّر أبداً، فلا يوجد هنا تعلّم للسمات. وهذا يعني أن كل ما سنراه سببه عدد المعاملات وحده.
وهناك تفصيل سنحتاجه لاحقاً. حين يكون p أكبر من عدد نقاط التدريب n، توجد متجهات أوزان لا نهاية لعددها تلائم بيانات التدريب ملاءمة تامّة. ومن بينها كلّها، يُعيد الحلّال المتّجه ذا المعيار الأصغر.
انتبه إلى السطر الأخير. إنه خطأ نموذج يتجاهل مُدخله ويتنبّأ دائماً بالمتوسط. وأيّ نموذج يستحق الاستخدام يجب أن يتفوّق عليه.
import numpy as np

cfg = env.cfg
n_train = cfg["n_train"]
n_test = cfg["n_test"]
dim = cfg["dim"]
noise = cfg["noise"]
p_max = cfg["p_max"]
trials = cfg["trials"]


def make_task(seed, n=n_train, label_noise=noise):
    # One trial = one hidden target function, one dataset, one bank of random
    # features. Every model width in a trial reuses the SAME data and the SAME
    # features (the first p columns), so the only thing that varies along the
    # sweep is the parameter count.
    rng = np.random.default_rng(seed)
    a = rng.normal(size=dim) / np.sqrt(dim)
    b = rng.normal(size=(4, dim))

    def target(x):
        # A linear part plus a few saturating bumps. Random ReLU features can
        # approximate this well, but never exactly.
        return 2.0 * (x @ a) + np.tanh(x @ b.T).sum(axis=1)

    x_tr = rng.normal(size=(n, dim))
    x_te = rng.normal(size=(n_test, dim))
    y_tr = target(x_tr) + label_noise * rng.normal(size=n)
    y_te = target(x_te)  # the test set is clean: we measure the real function
    w_feat = rng.normal(size=(p_max, dim)) / np.sqrt(dim)
    return {"x_tr": x_tr, "y_tr": y_tr, "x_te": x_te, "y_te": y_te, "w_feat": w_feat}


def features(x, w_feat, p):
    # Random ReLU features: a fixed, untrained first layer of width p.
    return np.maximum(x @ w_feat[:p].T, 0.0) / np.sqrt(p)


def fit(task, p, ridge=0.0):
    # Least squares on the first p features. With ridge = 0 and p > n there are
    # infinitely many exact fits; lstsq returns the one with the smallest norm.
    f_tr = features(task["x_tr"], task["w_feat"], p)
    f_te = features(task["x_te"], task["w_feat"], p)
    y = task["y_tr"]
    n = len(y)
    if ridge == 0.0:
        w = np.linalg.lstsq(f_tr, y, rcond=None)[0]
    elif p <= n:
        w = np.linalg.solve(f_tr.T @ f_tr + ridge * np.eye(p), f_tr.T @ y)
    else:
        w = f_tr.T @ np.linalg.solve(f_tr @ f_tr.T + ridge * np.eye(n), y)
    train_mse = float(np.mean((f_tr @ w - y) ** 2))
    test_mse = float(np.mean((f_te @ w - task["y_te"]) ** 2))
    return train_mse, test_mse, w


def width_grid(n):
    # Log-spaced widths from tiny to p_max, plus a dense band around p = n so
    # the threshold is sampled where the curve moves fastest.
    coarse = np.geomspace(5, p_max, cfg["grid_points"]).round().astype(int)
    band = np.arange(int(0.9 * n), int(1.1 * n) + 1, max(1, n // 40))
    return np.unique(np.concatenate([coarse, band, [n]]))


tasks = [make_task(cfg["seed"] + k) for k in range(trials)]
widths = width_grid(n_train)
target_var = round(float(np.mean([np.var(tk["y_te"]) for tk in tasks])), 2)

say(
    f"{trials} trials · {n_train} training points · {n_test} test points · "
    f"inputs in {dim} dimensions · label noise σ = {noise}",
    f"{trials} تجارب · {n_train} نقطة تدريب · {n_test} نقطة اختبار · "
    f"مدخلات في {dim} بُعداً · ضجيج التسميات σ = {noise}",
)
say(
    f"{len(widths)} model widths, from {widths[0]} to {widths[-1]} features",
    f"{len(widths)} عرضاً للنموذج، من {widths[0]} إلى {widths[-1]} سمة",
)
say(
    f"For scale: always predicting the mean scores a test MSE of {target_var:.2f}",
    f"للمقارنة: نموذج يتنبّأ دائماً بالمتوسط يحصل على خطأ اختبار قدره {target_var:.2f}",
)5 تجارب · 200 نقطة تدريب · 2000 نقطة اختبار · مدخلات في 20 بُعداً · ضجيج التسميات σ = 0.5
49 عرضاً للنموذج، من 5 إلى 4000 سمة
للمقارنة: نموذج يتنبّأ دائماً بالمتوسط يحصل على خطأ اختبار قدره 8.13المحوران لوغاريتميان. ابحث أولاً عن منحنى U الكلاسيكي في اليسار. ثم راقب الخط المتقطّع عند p = n: ماذا يفعل خطأ الاختبار هناك، وماذا يفعل خطأ التدريب في اللحظة نفسها؟
import matplotlib.pyplot as plt


def sweep(ridge=0.0, n=n_train, task_list=None):
    task_list = tasks if task_list is None else task_list
    grid = width_grid(n)
    train = np.zeros((len(task_list), len(grid)))
    test = np.zeros_like(train)
    for i, tk in enumerate(task_list):
        for j, p in enumerate(grid):
            train[i, j], test[i, j], _ = fit(tk, int(p), ridge)
    # Median over trials: exactly at p = n one unlucky trial can be off by
    # orders of magnitude, and a mean would let that one trial draw the curve.
    return grid, np.median(train, axis=0), np.median(test, axis=0)


grid, train_curve, test_curve = sweep()

under = grid < n_train
best_idx = int(np.argmin(np.where(under, test_curve, np.inf)))
sweet_spot_p = int(grid[best_idx])
sweet_spot_test = round(float(test_curve[best_idx]), 2)
threshold_test = round(float(test_curve[grid == n_train][0]), 1)
widest_test = round(float(test_curve[-1]), 2)
# Captured values are rounded here, because prose quotes them verbatim.
peak_ratio = round(threshold_test / sweet_spot_test)
second_descent = round(threshold_test / widest_test)
widest_vs_sweet_spot = round(widest_test / sweet_spot_test, 2)
train_r2_widest = 1.0 - float(train_curve[-1]) / float(
    np.mean([np.var(tk["y_tr"]) for tk in tasks])
)

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.plot(grid, test_curve, "o-", ms=3, label=t("test error", "خطأ الاختبار"))
# Past p = n the training error is zero to machine precision (around 1e-28).
# Drawn at its true value it would flatten everything else, so it is pinned to
# a floor: a point on the floor means "exactly fitted".
floor = 1e-2
ax.plot(
    grid,
    np.maximum(train_curve, floor),
    "s-",
    ms=3,
    alpha=0.7,
    label=t("training error", "خطأ التدريب"),
)
ax.axvline(n_train, color="grey", ls="--", lw=1)
ax.text(n_train * 1.08, floor * 2, "p = n", color="grey")
ax.scatter(
    [sweet_spot_p],
    [sweet_spot_test],
    s=80,
    facecolors="none",
    edgecolors="black",
    zorder=5,
    label=t("classical sweet spot", "النقطة المثلى الكلاسيكية"),
)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel(t("number of random features p (parameters)", "عدد السمات العشوائية p (المعاملات)"))
ax.set_ylabel(t("mean squared error (log scale)", "متوسط مربع الخطأ (مقياس لوغاريتمي)"))
ax.set_title(
    t(
        "Test error across the interpolation threshold",
        "خطأ الاختبار عبر عتبة الاستيفاء",
    )
)
ax.legend()
plt.show()

say(
    f"classical sweet spot   p = {sweet_spot_p:5d}   test MSE {sweet_spot_test:.3f}",
    f"النقطة المثلى الكلاسيكية   p = {sweet_spot_p:5d}   خطأ الاختبار {sweet_spot_test:.3f}",
)
say(
    f"interpolation threshold p = {n_train:5d}   test MSE {threshold_test:.3f}",
    f"عتبة الاستيفاء           p = {n_train:5d}   خطأ الاختبار {threshold_test:.3f}",
)
say(
    f"widest model           p = {int(grid[-1]):5d}   test MSE {widest_test:.3f}   "
    f"training MSE {train_curve[-1]:.1e}",
    f"أعرض نموذج              p = {int(grid[-1]):5d}   خطأ الاختبار {widest_test:.3f}   "
    f"خطأ التدريب {train_curve[-1]:.1e}",
)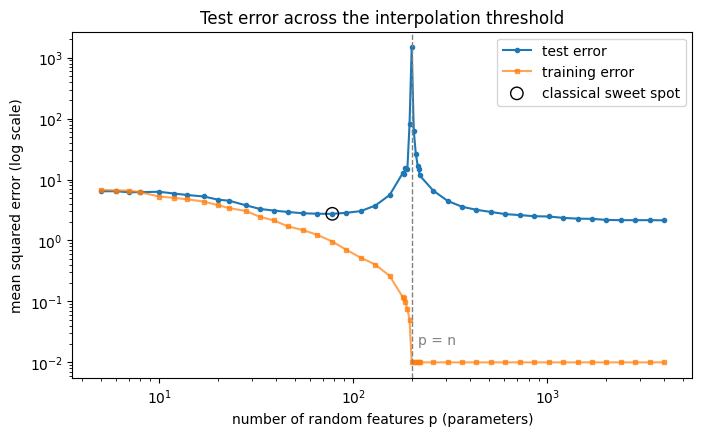
النقطة المثلى الكلاسيكية   p =    78   خطأ الاختبار 2.740
عتبة الاستيفاء           p =   200   خطأ الاختبار 1474.600
أعرض نموذج              p =  4000   خطأ الاختبار 2.140   خطأ التدريب 4.8e-29
ابدأ من اليسار. ينخفض خطأ الاختبار كلما أضفنا سمات. السبب أن النموذج في هذه المنطقة يقصر عن ملاءمة البيانات، فكل سمة جديدة تساعده. يبلغ الخطأ قاعه قرب p = 78، بقيمة 2.740، ثم يبدأ بالصعود. حتى هذه النقطة، هذا هو المنحنى الذي درسناه في المقرّر.
لكن الصعود لا يستقرّ. بل يتحوّل إلى قمّة حادّة. وتقع هذه القمّة تماماً عند p = n = 200، وهو العرض الذي يصل عنده خطأ التدريب إلى الصفر لأول مرة. خطأ الاختبار هناك 1474.600. أي أنه أكبر من خطأ النقطة المثلى بنحو 538 ضعفاً، وأسوأ بكثير من مجرّد التنبّؤ بالمتوسط.
بعد ذلك يعود المنحنى إلى الهبوط. ويحدث هذا مع أن خطأ التدريب يبقى صفراً على طول الطريق حتى 4000 سمة. ينتهي أعرض نموذج عند خطأ اختبار قدره 2.140، أي 0.780 من خطأ النقطة المثلى. بعبارة أخرى: نموذج يلائم كل تسمية تدريب ملاءمة تامّة، رغم ما فيها من ضجيج، ينتهي تقريباً في مستوى أفضل نموذج كانت القاعدة الكلاسيكية ستختاره.
إذا غيّرتَ البذرة العشوائية، تتحرّك هذه النسبة الأخيرة فوق الواحد أو تحته. أما القمّة فلا تتحرّك. تبقى عند p = n، وتبقى ضخمة.
لنعدّ الخيارات المتاحة للحلّال عند كل عرض. حين يكون العرض أقلّ من n، تكون الأوزان أقلّ من نقاط التدريب. فلا يوجد متجه أوزان يمرّ بكل النقاط. وتختار المربعات الصغرى أفضل حلّ وسط. وحين يكون العرض أكبر من n، تكون الأوزان أكثر من النقاط. فتوجد متجهات أوزان لا نهاية لعددها تمرّ بكل النقاط تماماً، ويختار الحلّال أصغرها.
أما عند p = n تماماً، فتوجد ملاءمة تامّة واحدة، ولا مجال للاختيار. هذه الملاءمة الوحيدة مُجبرة على المرور بكل تسمية، بما فيها من ضجيج. ولكي تفعل ذلك، تحتاج الأوزان في العادة إلى أن تكبر كثيراً. والأوزان الكبيرة تجعل تنبّؤات النموذج تتأرجح بعنف بين نقاط التدريب. إذا كان هذا التفسير صحيحاً، فيجب أن يقفز حجم الأوزان في الموضع نفسه الذي يقفز فيه خطأ الاختبار.
قارن شكل هذا المنحنى بمنحنى خطأ الاختبار أعلاه. هل تقع القمّة عند العرض نفسه؟
# The size of the fitted weights, across the same sweep. Large weights mean the
# model reacts violently to small changes in its input — including the noise.
norm_curve = np.median([[np.linalg.norm(fit(tk, int(p))[2]) for p in grid] for tk in tasks], axis=0)
threshold_norm = round(float(norm_curve[grid == n_train][0]))
widest_norm = round(float(norm_curve[-1]))
sweet_spot_norm = round(float(norm_curve[best_idx]))

fig, ax = plt.subplots(figsize=(8, 3.5))
ax.plot(grid, norm_curve, "o-", ms=3, color="tab:purple")
ax.axvline(n_train, color="grey", ls="--", lw=1)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel(t("number of random features p (parameters)", "عدد السمات العشوائية p (المعاملات)"))
ax.set_ylabel(t("weight norm ‖w‖ (log scale)", "معيار الأوزان ‖w‖ (مقياس لوغاريتمي)"))
ax.set_title(
    t(
        "The fitted weights blow up exactly at p = n",
        "الأوزان المُلائَمة تنفجر عند p = n تماماً",
    )
)
plt.show()

say(
    f"weight norm at the sweet spot   p = {sweet_spot_p:5d}: {sweet_spot_norm}",
    f"معيار الأوزان عند النقطة المثلى  p = {sweet_spot_p:5d}: {sweet_spot_norm}",
)
say(
    f"weight norm at the threshold    p = {n_train:5d}: {threshold_norm}",
    f"معيار الأوزان عند العتبة         p = {n_train:5d}: {threshold_norm}",
)
say(
    f"weight norm at the widest model p = {int(grid[-1]):5d}: {widest_norm}",
    f"معيار الأوزان عند أعرض نموذج     p = {int(grid[-1]):5d}: {widest_norm}",
)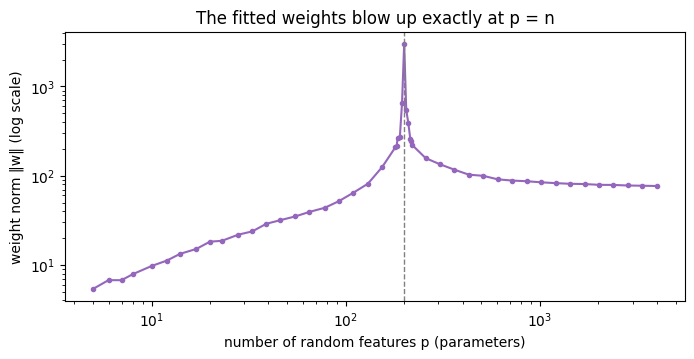
معيار الأوزان عند النقطة المثلى  p =    78: 44
معيار الأوزان عند العتبة         p =   200: 3005
معيار الأوزان عند أعرض نموذج     p =  4000: 77
نعم، تقع عنده. يرتفع معيار الأوزان من 44 عند النقطة المثلى إلى 3,005 عند العتبة. ثم يعود فينخفض إلى 77 عند أعرض نموذج. بعد n، كل سمة إضافية تمنح الحلّال طرقاً أكثر لملاءمة النقاط نفسها. ولذلك تزداد أصغر ملاءمة تامّة صِغَراً ونعومة.
هذا يغيّر معنى عبارة «معاملات أكثر». في الصورة الكلاسيكية، كل معامل إضافي يعني حرية أكبر للإفراط في الملاءمة. أما بعد العتبة، فكل معامل إضافي يعني مجالاً أوسع لملاءمة البيانات نفسها برفق. إذن السعة وحدها لا تحدّد . ما يحدّده هو أيّ ملاءمة تامّة، من بين ملاءمات كثيرة، ينتهي إليها النموذج.
الملاءمة الأصغر كانت اختيار الحلّال. هنا نستخدم انحداراً تدرّجياً عادياً يبدأ من أوزان صفرية، ولا يُطلب منه إبقاء الأوزان صغيرة. انظر إلى تشابه جيب التمام: القيمة 1 تعني الاتجاه نفسه.
# Past p = n there are infinitely many weight vectors with zero training error.
# lstsq picks the smallest one. Does ordinary gradient descent pick the same?
gd_task = tasks[0]
gd_p = cfg["gd_width"]
f_gd = features(gd_task["x_tr"], gd_task["w_feat"], gd_p)
y_gd = gd_task["y_tr"]
_, _, w_min_norm = fit(gd_task, gd_p)

w = np.zeros(gd_p)  # start at the origin, as the result depends on it
step = 1.0 / np.linalg.norm(f_gd, 2) ** 2
for _ in range(cfg["gd_steps"]):
    w -= step * f_gd.T @ (f_gd @ w - y_gd)

gd_train_mse = float(np.mean((f_gd @ w - y_gd) ** 2))
gd_cosine = round(float(w @ w_min_norm / (np.linalg.norm(w) * np.linalg.norm(w_min_norm))), 4)
say(
    f"p = {gd_p}: gradient descent reached training MSE {gd_train_mse:.1e}",
    f"عند p = {gd_p}: وصل الانحدار التدرّجي إلى خطأ تدريب {gd_train_mse:.1e}",
)
say(
    f"cosine similarity to the minimum-norm solution: {gd_cosine:.4f}",
    f"تشابه جيب التمام مع الحلّ ذي المعيار الأصغر: {gd_cosine:.4f}",
)
say(
    f"weight norms — gradient descent {np.linalg.norm(w):.1f}, "
    f"minimum norm {np.linalg.norm(w_min_norm):.1f}",
    f"معيار الأوزان — الانحدار التدرّجي {np.linalg.norm(w):.1f}، "
    f"الحلّ الأصغر {np.linalg.norm(w_min_norm):.1f}",
)عند p = 1000: وصل الانحدار التدرّجي إلى خطأ تدريب 4.6e-05
تشابه جيب التمام مع الحلّ ذي المعيار الأصغر: 0.9999
معيار الأوزان — الانحدار التدرّجي 93.6، الحلّ الأصغر 94.3يصل الانحدار التدرّجي إلى الملاءمة ذات المعيار الأصغر، بتشابه جيب تمام قدره 1.000. والسبب آليّ بحت. كل خطوة تدرّج هي تركيبة خطية من مُدخلات التدريب. فإذا بدأنا من الصفر، لا تكتسب الأوزان أبداً أيّ مركّبة لا تراها البيانات. والملاءمة التامّة الوحيدة الخالية من مثل هذه المركّبات هي الملاءمة الأصغر.
إذن لم يحتج أحد إلى اختيار الملاءمة الأصغر، بل اختارها المُحسِّن بنفسه. هذا ما نسمّيه الانحياز الاستقرائي: تفضيل مبنيّ في الإجراء نفسه، وغير مكتوب في دالّة الخسارة. في الشبكات العميقة تختلف التفاصيل، لكن الدرس يبقى صالحاً. لكي تتنبّأ بقدرة نموذج كثير المعاملات على التعميم، يجب أن تعرف كيف دُرِّب، لا حجمه فقط.
النموذج الأعرض نفسه، والمُدخلات نفسها، لكن التسميات مخلوطة. قارن خطأي التدريب أولاً، ثم خطأي الاختبار.
# Same widest model, same inputs, but the training labels are shuffled, so
# there is no function left to learn. Can it still fit them?
shuffled = []
for k, tk in enumerate(tasks):
    rng = np.random.default_rng(cfg["seed"] + 1000 + k)
    shuffled.append(dict(tk, y_tr=rng.permutation(tk["y_tr"])))

mem = np.array([fit(tk, p_max)[:2] for tk in shuffled])
shuffled_train_mse = float(np.median(mem[:, 0]))
shuffled_test_mse = round(float(np.median(mem[:, 1])), 2)

say(
    f"p = {p_max}, true labels:     training MSE {train_curve[-1]:.1e}   test MSE {widest_test:.3f}",
    f"عند p = {p_max}، التسميات الحقيقية:  خطأ التدريب {train_curve[-1]:.1e}   خطأ الاختبار {widest_test:.3f}",
)
say(
    f"p = {p_max}, shuffled labels: training MSE {shuffled_train_mse:.1e}   test MSE {shuffled_test_mse:.3f}",
    f"عند p = {p_max}، التسميات المخلوطة:  خطأ التدريب {shuffled_train_mse:.1e}   خطأ الاختبار {shuffled_test_mse:.3f}",
)
say(
    f"predicting the mean:          test MSE {target_var:.3f}",
    f"التنبّؤ بالمتوسط:                    خطأ الاختبار {target_var:.3f}",
)عند p = 4000، التسميات الحقيقية: خطأ التدريب 4.8e-29 خطأ الاختبار 2.140
عند p = 4000، التسميات المخلوطة: خطأ التدريب 1.8e-28 خطأ الاختبار 21.370
التنبّؤ بالمتوسط: خطأ الاختبار 8.130خطأ التدريب صفر في الحالتين. أي أن أعرض نموذج يحفظ التسميات المخلوطة بالكمال نفسه الذي يحفظ به التسميات الحقيقية. لكن خطأي الاختبار لا يتشابهان أبداً. على التسميات الحقيقية يبلغ 2.140. وعلى التسميات المخلوطة يبلغ 21.370، وهذا أسوأ من التنبّؤ الدائم بالمتوسط (8.130).
لهذا لا تكفي عبارة «النموذج كبير بما يكفي ليحفظ البيانات» لتفسير الإفراط في الملاءمة. النموذج نفسه، بالحجم نفسه، يعمّم جيداً على مجموعة بيانات ويفشل على أخرى. الفرق إذن في البيانات نفسها. وتحديداً في سلوك الملاءمة الناعمة التي تمرّ بها، في المسافات الواقعة بين النقاط.
إذا كانت القمّة ناتجة عن إجبار النموذج على ملاءمة تامّة لتسميات فيها ضجيج، فالسماح بملاءمة غير تامّة قليلاً يجب أن يُزيلها. وهذا ما يفعله انحدار الحافّة (ridge). يضيف هذا الانحدار عقوبة تساوي λ مضروبة في مربع معيار الأوزان. فيتنازل الحلّال عن قليل من دقّة التدريب مقابل إبقاء الأوزان صغيرة. الخلية التالية تعيد المسح نفسه، على البيانات نفسها، مع λ = 0.01.
المنحنى الباهت هو المسح الأول، والخط المنقّط هو النقطة المثلى الكلاسيكية. ابحث عن أمرين: هل تبقى القمّة؟ وأين يقع أفضل نموذج الآن؟
ridge = cfg["ridge"]
_, ridge_train_curve, ridge_test_curve = sweep(ridge=ridge)

ridge_threshold_test = round(float(ridge_test_curve[grid == n_train][0]), 2)
ridge_widest_test = round(float(ridge_test_curve[-1]), 2)
ridge_vs_sweet_spot = round(ridge_widest_test / sweet_spot_test, 2)
# How much does the regularized curve ever climb as p grows? 1.0 = never.
ridge_worst_climb = round(
    float(np.max(ridge_test_curve / np.minimum.accumulate(ridge_test_curve))), 2
)

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.plot(
    grid,
    test_curve,
    "o-",
    ms=3,
    alpha=0.5,
    label=t("no penalty (minimum norm)", "بلا عقوبة (المعيار الأصغر)"),
)
ax.plot(
    grid,
    ridge_test_curve,
    "o-",
    ms=3,
    label=t(f"ridge λ = {ridge}", f"عقوبة الحافّة λ = {ridge}"),
)
ax.axhline(
    sweet_spot_test,
    color="black",
    ls=":",
    lw=1,
    label=t("classical sweet spot", "النقطة المثلى الكلاسيكية"),
)
ax.axvline(n_train, color="grey", ls="--", lw=1)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel(t("number of random features p (parameters)", "عدد السمات العشوائية p (المعاملات)"))
ax.set_ylabel(t("test MSE (log scale)", "خطأ الاختبار (مقياس لوغاريتمي)"))
ax.set_title(t("A small penalty removes the peak", "عقوبة صغيرة تُزيل القمّة"))
ax.legend()
plt.show()

say(
    f"at p = n:      no penalty {threshold_test:.3f}   ridge {ridge_threshold_test:.3f}",
    f"عند p = n:      بلا عقوبة {threshold_test:.3f}   مع الحافّة {ridge_threshold_test:.3f}",
)
say(
    f"widest model:  no penalty {widest_test:.3f}   ridge {ridge_widest_test:.3f}   "
    f"(classical sweet spot {sweet_spot_test:.3f})",
    f"أعرض نموذج:     بلا عقوبة {widest_test:.3f}   مع الحافّة {ridge_widest_test:.3f}   "
    f"(النقطة المثلى الكلاسيكية {sweet_spot_test:.3f})",
)
say(
    f"largest climb of the ridge curve above its running best: ×{ridge_worst_climb:.2f}",
    f"أكبر صعود لمنحنى الحافّة فوق أفضل قيمة سبقته: ×{ridge_worst_climb:.2f}",
)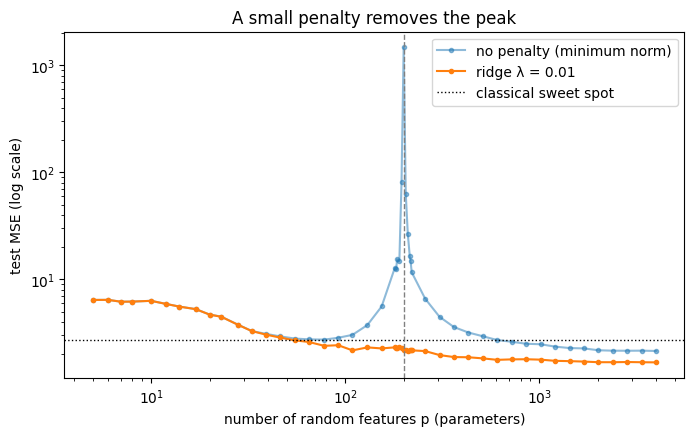
عند p = n:      بلا عقوبة 1474.600   مع الحافّة 2.200
أعرض نموذج:     بلا عقوبة 2.140   مع الحافّة 1.680   (النقطة المثلى الكلاسيكية 2.740)
أكبر صعود لمنحنى الحافّة فوق أفضل قيمة سبقته: ×1.07
اختفت القمّة. عند p = n يحقّق النموذج المنظَّم خطأ اختبار قدره 2.200، مقابل 1474.600 من دون العقوبة. وصار المنحنى قريباً من أن يكون متناقصاً باستمرار. فأكبر صعود له، في أيّ موضع، فوق أفضل قيمة بلغها قبل ذلك، لا يزيد على مُضاعِف قدره 1.070.
لكن التغيير الأكبر يقع في الطرف الأيمن. يبلغ أعرض نموذج منظَّم خطأ اختبار قدره 1.680، أي 0.610 من خطأ النقطة المثلى الكلاسيكية. إذن أفضل نموذج في الورشة كلّها هو أكبرها، مع عقوبة صغيرة. وعلى خلاف النسبة في المسح الأول بلا عقوبة، ثبتت هذه النتيجة في كل بذرة عشوائية جُرِّبت أثناء بناء الورشة.
إذن تبقى المفاضلة بين الانحياز والتباين صحيحة، لكن محورها كان موسوماً خطأً. التباين لا يكبر مع عدد المعاملات. بل ينفجر حين يقترب عدد المعاملات من عدد نقاط التدريب، وتكون الملاءمة مُجبرة على أن تكون تامّة. ابتعد عن تلك النقطة في أيّ اتجاه، أو خفّف شرط الملاءمة التامّة، فتكفّ المعاملات الإضافية عن الإضرار بالنموذج.
تمرين
الخلية التالية تضاعف مجموعة التدريب إلى 2n. قبل أن تشغّلها، ضع في my_guess العرض الذي تتوقّع أن تقع عنده القمّة الجديدة. ثم جرّب تنصيف البيانات بدلاً من مضاعفتها. السؤال الذي نريد حسمه: هل موضع القمّة خاصية للنموذج وحده، أم للنموذج والبيانات معاً؟ بعد ذلك اقرأ السطر الأخير. ستجد أن النموذج نفسه، قرب القمّة الجديدة، يصبح أسوأ حين نعطيه بيانات أكثر.
# YOUR TURN.
#
# Double the training set. Before running, write down where you expect the
# peak to move — or whether it moves at all. Then try halving it.
n_new = 2 * n_train  # try n_train // 2 as well
my_guess = None  # your predicted peak location, as a width p

new_tasks = [make_task(cfg["seed"] + k, n=n_new) for k in range(trials)]
new_grid, _, new_test = sweep(n=n_new, task_list=new_tasks)
new_peak_p = int(new_grid[int(np.argmax(new_test))])
say(
    f"n = {n_new}: the test error peaks at p = {new_peak_p}"
    f" (with n = {n_train}, it peaked at p = {int(grid[int(np.argmax(test_curve))])})",
    f"عند n = {n_new}: تبلغ قمّة خطأ الاختبار p = {new_peak_p}"
    f" (وعند n = {n_train} كانت القمّة عند p = {int(grid[int(np.argmax(test_curve))])})",
)
# The same width, under the old and the new dataset size.
same_width_old = float(np.median([fit(tk, n_new)[1] for tk in tasks]))
same_width_new = float(new_test[new_grid == n_new][0])
say(
    f"a model with p = {n_new} features: test MSE {same_width_old:.2f} with "
    f"{n_train} training points, {same_width_new:.2f} with {n_new}",
    f"نموذج بـ p = {n_new} سمة: خطأ الاختبار {same_width_old:.2f} مع "
    f"{n_train} نقطة تدريب، و{same_width_new:.2f} مع {n_new}",
)
if my_guess is not None:
say(f"your guess: p = {my_guess}", f"تخمينك: p = {my_guess}")يتوفّر تلميح في الدفتر — env.hint(1)
الفحص الأول هو فحص الضبط. إذا لم يلائم أعرض نموذج بيانات تدريبه ملاءمة تامّة، فانخفاض خطأ اختباره لا يعني إلا أنه يقصر عن الملاءمة. وعندها لا يعني الهبوط الثاني شيئاً.
# The control first: if the widest model did not actually interpolate the
# training set, the "second descent" would be an underfit model, not a
# memorizing one, and the comparison would show nothing.
interpolates_ok = env.check("widest-model-interpolates", train_r2_widest)
peak_ok = env.check("peak-at-threshold", peak_ratio)
descent_ok = env.check("second-descent", second_descent)✓ نسبة تباين تسميات التدريب التي يلائمها أعرض نموذج (<bdi dir="ltr">R²</bdi>): 1 (المطلوب ≥ 0.999)
✓ خطأ الاختبار عند العتبة مقسوماً على خطأ النقطة المثلى الكلاسيكية: 538 (المطلوب ≥ 20)
✓ خطأ الاختبار عند العتبة مقسوماً على خطأ أعرض نموذج: 689 (المطلوب ≥ 20)يسجّل الإيصال الفحوص التي نجحت، وملفّ التشغيل المستخدم، وبصمة الشيفرة.
receipt = env.receipt()اكتملت الورشة.
رمز الإتمام: AZ-██████████
الصقه في صفحة الورشة على أزيموث لتسجيل إتمامها.القاعدة التي نخرج بها ليست «الأكبر أفضل دائماً». فأعرض نموذج بلا تنظيم لم يزد على أن جارى النقطة المثلى الكلاسيكية. والبذرة العشوائية هي التي حدّدت هل وقع فوقها أم تحتها. القاعدة المصحّحة أضيق من ذلك، وأنفع. يبلغ خطأ الاختبار ذروته حين يلتقي عدد المعاملات بعدد نقاط التدريب، وتكون الملاءمة مُجبرة على أن تكون تامّة. بعد تلك النقطة، يتولّى الأمرَ تفضيلُ المُحسِّن للحلول الصغيرة الناعمة. ومع قليل من التنظيم، يصبح أكبر نموذج هو أفضلها.
مصطلحات هذه الورشة
- التعميمGeneralization
- فرط التخصيصOverfitting
- ضعف مواءمة البيانات (التعلم الناقص)Underfitting
- الأمثَلَةOptimization
- الحفظMemorization