الشبكات العصبيةintermediateمعالج رسوميات اختياري~30 دقيقةColab
كشف الشذوذ بالمُرمِّز الذاتي
Anomaly detection with an autoencoder
خطأ إعادة البناء بوصفه مسافة
لديك خمسة آلاف تسجيل لنبضات القلب، لكن التسميات شبه معدومة للحالات غير الطبيعية، لأنها بالضبط ما لم يجمع منه أحد ما يكفي. وهذا هو الوضع المعتاد في : الفئة النادرة في الواقع نادرة في بيانات التدريب أيضاً، فلا يجد المصنّف ما يتعلّم منه. لذلك نغيّر الخطة. ندرّب نموذجاً على الحالات الطبيعية وحدها، وحين يعجز عن إعادة بناء شيء لم يألفه، يصبح هذا العجز نفسه هو إشارة الإنذار.
الهدف
درّب مُرمِّزاً ذاتياً على النبضات الطبيعية فقط، ثم اختر العتبة من توزيع خطأ إعادة البناء لا بالتخمين، وحقّق قيمة F1 لا تقل عن 0.90 على مجموعة اختبار منفصلة تضم الفئتين معاً.
يفتح Colab نسخة للقراءة فقط. احفظ نسخة في Drive للاحتفاظ بتعديلاتك.
يحتاج الدفتر إلى لوحة مفاتيح — يُفضَّل فتحه على حاسوب مكتبي.
الأوراق وراء هذه الورشة
في العادي تحتاج أمثلة من كل فئة حتى يتعلّم النموذج التمييز بينها. أما في كشف الشذوذ فلا تملك هذه الأمثلة. الحالات الشاذة نادرة بطبيعتها، فتعاني البيانات من بشكل حادّ. والقليل المتاح منها لا يمثّل كل الأشكال التي قد تواجهها لاحقاً.
لذلك نقلب السؤال. بدل أن نعلّم النموذج شكل الشذوذ، نعلّمه شكل الوضع الطبيعي. نبني مهمّته سهلة: أن يعيد إنتاج مدخلاته كما هي. لكنّنا نجبر البيانات على المرور عبر ضيّق لا يتّسع لنسخ كل التفاصيل. ولأن المساحة محدودة، سيصرفها النموذج على ما يتكرّر كثيراً في بيانات التدريب، أي على الأنماط الطبيعية. أعطه بعد ذلك شيئاً غير مألوف، وسيفشل في إعادة بنائه. وهذا الفشل تحديداً هو إشارة الإنذار.
تهيئة أوّلية: نتأكد من جاهزية البيئة وسلامة البيانات قبل بدء التدريب.
import azimuth_nb as azimuth

env = azimuth.setup(SLUG, lang=LANG, profile=PROFILE)كشف الشذوذ بمرمّز ذاتي
بدون معالج رسوميات · ذاكرة 3.9 غ.ب · PyTorch 2.2.2+cu121
الملف: free
البيانات:
· ecg5000.csv — already present
جاهز · epochs=160, batchSize=128, latentDim=8, hidden=[64, 32], learningRate=0.001, seed=17انتبه للتقسيم: مجموعة التدريب لا تحتوي إلا على تسجيلات طبيعية. وهذه هي الطريقة كلّها.
import numpy as np

raw = np.loadtxt(env.assets["ecg5000.csv"], delimiter=",")
traces, labels = raw[:, :-1].astype(np.float32), raw[:, -1].astype(int)

# Min-max to [0, 1] using TRAINING statistics only. Fitting the scaler on
# everything would leak the abnormal range into the normal model — a quiet
# mistake that inflates every number downstream.
rng = np.random.default_rng(env.cfg["seed"])
order = rng.permutation(len(traces))
traces, labels = traces[order], labels[order]

split = int(0.8 * len(traces))
train_all, test_x = traces[:split], traces[split:]
train_labels, test_y = labels[:split], labels[split:]

# THE METHOD, IN ONE LINE: the model only ever sees normal traces.
train_x = train_all[train_labels == 1]

lo, hi = train_x.min(), train_x.max()
train_x = (train_x - lo) / (hi - lo)
test_x = (test_x - lo) / (hi - lo)

n_normal = int((test_y == 1).sum())
n_abnormal = int((test_y == 0).sum())
class_balance = {
    "trainNormal": len(train_x),
    "testNormal": n_normal,
    "testAbnormal": n_abnormal,
}

if env.lang == "ar":
    print(f"التدريب: {len(train_x)} أثراً طبيعياً فقط")
    print(f"الاختبار: {n_normal} طبيعي · {n_abnormal} شاذ")
else:
    print(f"train: {len(train_x)} normal traces only")
print(f"test: {n_normal} normal · {n_abnormal} abnormal")التدريب: 2338 أثراً طبيعياً فقط
الاختبار: 581 طبيعي · 419 شاذimport torch
import torch.nn as nn
torch.manual_seed(env.cfg["seed"])
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
n_features = train_x.shape[1]
class Autoencoder(nn.Module):
"""Symmetric encoder/decoder around a deliberately narrow layer.
The bottleneck width is the entire experiment. Widen it and the model
learns the identity function and reconstructs abnormal traces just as well
as normal ones — at which point there is no detector left, only a copier.
"""
def __init__(self, n_features: int, hidden: list[int], latent: int):
super().__init__()
widths = [n_features, *hidden]
encoder: list[nn.Module] = []
for a, b in zip(widths[:-1], widths[1:]):
encoder += [nn.Linear(a, b), nn.ReLU()]
encoder += [nn.Linear(widths[-1], latent), nn.ReLU()]
self.encoder = nn.Sequential(*encoder)
decoder: list[nn.Module] = []
rev = [latent, *hidden[::-1]]
for a, b in zip(rev[:-1], rev[1:]):
decoder += [nn.Linear(a, b), nn.ReLU()]
# Sigmoid because the inputs were scaled to [0, 1]: the output range
# should be able to reach the input range and no further.
decoder += [nn.Linear(rev[-1], n_features), nn.Sigmoid()]
self.decoder = nn.Sequential(*decoder)
def forward(self, x):
return self.decoder(self.encoder(x))
model = Autoencoder(n_features, list(env.cfg["hidden"]), env.cfg["latentDim"]).to(device)
param_count = sum(p.numel() for p in model.parameters())
env.explain("bottleneck")
if env.lang == "ar":
print(f"عنق الزجاجة: {env.cfg['latentDim']} من أصل {n_features} بُعداً · {param_count:,} معامل")
else:
print(f"bottleneck: {env.cfg['latentDim']} of {n_features} dims · {param_count:,} parameters")bottleneck — أضيق طبقة في المرمّز الذاتي. عرضها هو الميزانية: على النموذج أن يصف المدخل كله بهذا العدد من الأرقام.
عنق الزجاجة: 8 من أصل 140 بُعداً · 22,868 معاملراقب شكل المنحنى، لا الرقم الأخير وحده. تهبط الخسارة بسرعة في البداية، ثم تستقر على هضبة لعشرين أو ثلاثين حقبة، ثم تعاود الانخفاض. ما يحدث عند الهضبة أن النموذج انتهى من تحسين الشكل المتوسط للنبضة، وبعدها بدأ يلتقط التفاصيل التي كان يطمسها بهذا المتوسط. لو أوقفت التدريب عند الهضبة، فستنشر كاشفاً لم يكتمل تدريبه، مع أنه يبدو وكأنه وصل إلى التقارب.
from torch.utils.data import DataLoader, TensorDataset

train_t = torch.from_numpy(train_x).to(device)
loader = DataLoader(
    TensorDataset(train_t, train_t),
    batch_size=env.cfg["batchSize"],
    shuffle=True,
)

optimizer = torch.optim.Adam(model.parameters(), lr=env.cfg["learningRate"])
criterion = nn.MSELoss()

loss_curve = []
model.train()
for epoch in range(env.cfg["epochs"]):
    total = 0.0
    for batch_x, batch_y in loader:
        optimizer.zero_grad()
        loss = criterion(model(batch_x), batch_y)
        loss.backward()
        optimizer.step()
        total += loss.item() * len(batch_x)
    epoch_loss = total / len(train_t)
    loss_curve.append(epoch_loss)
    if epoch % 10 == 0 or epoch == env.cfg["epochs"] - 1:
        print(f"epoch {epoch:3d}  loss {epoch_loss:.5f}")

final_loss = loss_curve[-1]epoch 0 loss 0.02346
epoch 10 loss 0.00169
epoch 20 loss 0.00169
epoch 30 loss 0.00168
epoch 40 loss 0.00166
epoch 50 loss 0.00160
epoch 60 loss 0.00123
epoch 70 loss 0.00114
epoch 80 loss 0.00093
epoch 90 loss 0.00075
epoch 100 loss 0.00071
epoch 110 loss 0.00070
epoch 120 loss 0.00068
epoch 130 loss 0.00066
epoch 140 loss 0.00062
epoch 150 loss 0.00058
epoch 159 loss 0.00057هذا هو الرسم الذي بُنيت الورشة كلها من أجله: توزيعان، والمسافة بينهما.
import matplotlib.pyplot as plt


def reconstruction_error(x: np.ndarray) -> np.ndarray:
    """Mean absolute error per trace — one number for each recording.

    L1 rather than L2 on purpose: squared error lets a single badly-missed
    sample dominate a trace's score, which makes the threshold sensitive to
    noise rather than to shape.
    """
    model.eval()
    with torch.no_grad():
        t = torch.from_numpy(x).to(device)
        return torch.mean(torch.abs(model(t) - t), dim=1).cpu().numpy()


train_errors = reconstruction_error(train_x)
test_errors = reconstruction_error(test_x)

normal_errors = test_errors[test_y == 1]
abnormal_errors = test_errors[test_y == 0]
separation = float(abnormal_errors.mean() / normal_errors.mean())

env.explain("reconstruction error")
fig, ax = plt.subplots(figsize=(7, 3.6))
bins = np.linspace(0, float(np.percentile(test_errors, 99.5)), 60)
ax.hist(normal_errors, bins=bins, alpha=0.75, label="normal", color="#2a9d8f")
ax.hist(abnormal_errors, bins=bins, alpha=0.75, label="abnormal", color="#e76f51")
ax.set_xlabel("reconstruction error (MAE)")
ax.set_ylabel("traces")
ax.legend()
ax.spines[["top", "right"]].set_visible(False)
fig.tight_layout()
plt.show()

print(f"normal mean   {normal_errors.mean():.4f}")
print(f"abnormal mean {abnormal_errors.mean():.4f}")
separation_ok = env.check("separation", separation)reconstruction error — مقدار بُعد المخرج عن المدخل. يكون صغيراً على البيانات التي دُرّب عليها النموذج، وكبيراً على ما لم يألفه، وهذه الفجوة هي الكاشف.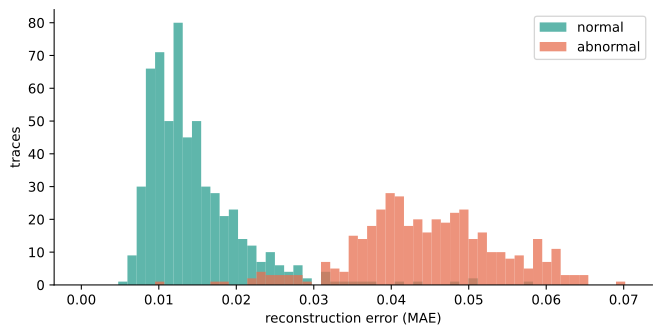
normal mean   0.0146
abnormal mean 0.0452
✓ خطأ الشاذ منسوباً إلى خطأ الطبيعي: 3.103 (المطلوب ≥ 2.5)
تمرين
حدّد بنفسك. أول ما يخطر بالبال هو تجريب قيم مختلفة حتى يبلغ أعلى قيمة له. لكن هذا يعني أنك تستعمل تسميات الحالات الشاذة، ولن تكون هذه التسميات متاحة لك يوم تنشر النموذج فعلياً. استخدم أخطاء التدريب بدلاً من ذلك: اختر من توزيع الأخطاء على بيانات سبق أن رآها النموذج، واشرح لماذا اخترت هذا الرقم.
بعد ذلك تأمّل ما تقوله الأرقام أعلاه. تدريب النموذج 160 حقبة بدل 60 رفع نسبة الفصل من 2.5× إلى 3.1×، أي أن التوزيعين تباعدا فعلاً. ومع ذلك لم تتحرّك قيمة F1. السبب أن ارتفعت بقدر ما انخفض ، فتعادل المكسب والخسارة.
ماذا يعني ذلك؟ الكاشف لم يعد محدوداً بجودة النموذج، بل بالعتبة التي تختارها في هذه الخلية. ابحث عن عتبة ترفع F1 فوق 0.949، ولاحظ أنك فعلت ذلك دون إعادة تدريب أي شيء.
# YOUR TURN.
#
# Pick a percentile of `train_errors` — the errors on traces the model was
# trained on. Anything you can compute from this array is available on the day
# you deploy, with no abnormal examples in hand. Anything you compute from
# `abnormal_errors` is not.
#
# Start here and change the number, with a reason:
PERCENTILE = 95

threshold = float(np.percentile(train_errors, PERCENTILE))
print(f"threshold = {threshold:.4f} (p{PERCENTILE} of training error)")يتوفّر تلميح في الدفتر — env.hint(2)
predicted_abnormal = test_errors > threshold
actually_abnormal = test_y == 0

tp = int((predicted_abnormal & actually_abnormal).sum())
fp = int((predicted_abnormal & ~actually_abnormal).sum())
fn = int((~predicted_abnormal & actually_abnormal).sum())
tn = int((~predicted_abnormal & ~actually_abnormal).sum())

precision = tp / (tp + fp) if (tp + fp) else 0.0
recall = tp / (tp + fn) if (tp + fn) else 0.0
f1 = 2 * precision * recall / (precision + recall) if (precision + recall) else 0.0
confusion = {"tp": tp, "fp": fp, "fn": fn, "tn": tn}

if env.lang == "ar":
    print(f"الدقة {precision:.3f} · الاستدعاء {recall:.3f} · F1 {f1:.3f}")
    print(f"أخطأ في {fn} حالة شاذة، وأنذر زوراً في {fp} حالة طبيعية")
else:
    print(f"precision {precision:.3f} · recall {recall:.3f} · F1 {f1:.3f}")
    print(f"missed {fn} abnormal · false-alarmed on {fp} normal")

f1_ok = env.check("f1", f1)الدقة 0.925 · الاستدعاء 0.969 · F1 0.946
أخطأ في 13 حالة شاذة، وأنذر زوراً في 33 حالة طبيعية
✓ مقياس F1 على مجموعة الاختبار: 0.9464 (المطلوب ≥ 0.9)حقّقت غابة العزل قيمة F1 قدرها 0.780، مقابل 0.946 للمُرمِّز الذاتي. الهدف من المقارنة ليس تحديد الفائز. السؤال الحقيقي: أيّهما كنت ستنشر فعلاً في بيئة الإنتاج؟
from sklearn.ensemble import IsolationForest

forest = IsolationForest(
    n_estimators=100,
    contamination=n_abnormal / len(test_y),
    random_state=env.cfg["seed"],
)
forest.fit(train_x)
forest_abnormal = forest.predict(test_x) == -1

b_tp = int((forest_abnormal & actually_abnormal).sum())
b_fp = int((forest_abnormal & ~actually_abnormal).sum())
b_fn = int((~forest_abnormal & actually_abnormal).sum())
b_precision = b_tp / (b_tp + b_fp) if (b_tp + b_fp) else 0.0
b_recall = b_tp / (b_tp + b_fn) if (b_tp + b_fn) else 0.0
baseline_f1 = (
    2 * b_precision * b_recall / (b_precision + b_recall) if (b_precision + b_recall) else 0.0
)

print(f"isolation forest F1 {baseline_f1:.3f} · autoencoder F1 {f1:.3f}")isolation forest F1 0.780 · autoencoder F1 0.946الإيصال: رمز الإتمام والأرقام التي بُني عليها.
receipt = env.receipt()اكتملت الورشة.
رمز الإتمام: AZ-██████████
الصقه في صفحة الورشة على أزيموث لتسجيل إتمامها.مصطلحات هذه الورشة
- عنق الزجاجةBottleneck
- خطأ إعادة البناءReconstruction Error
- العتبةThreshold
- الفضاء الكامنLatent Space